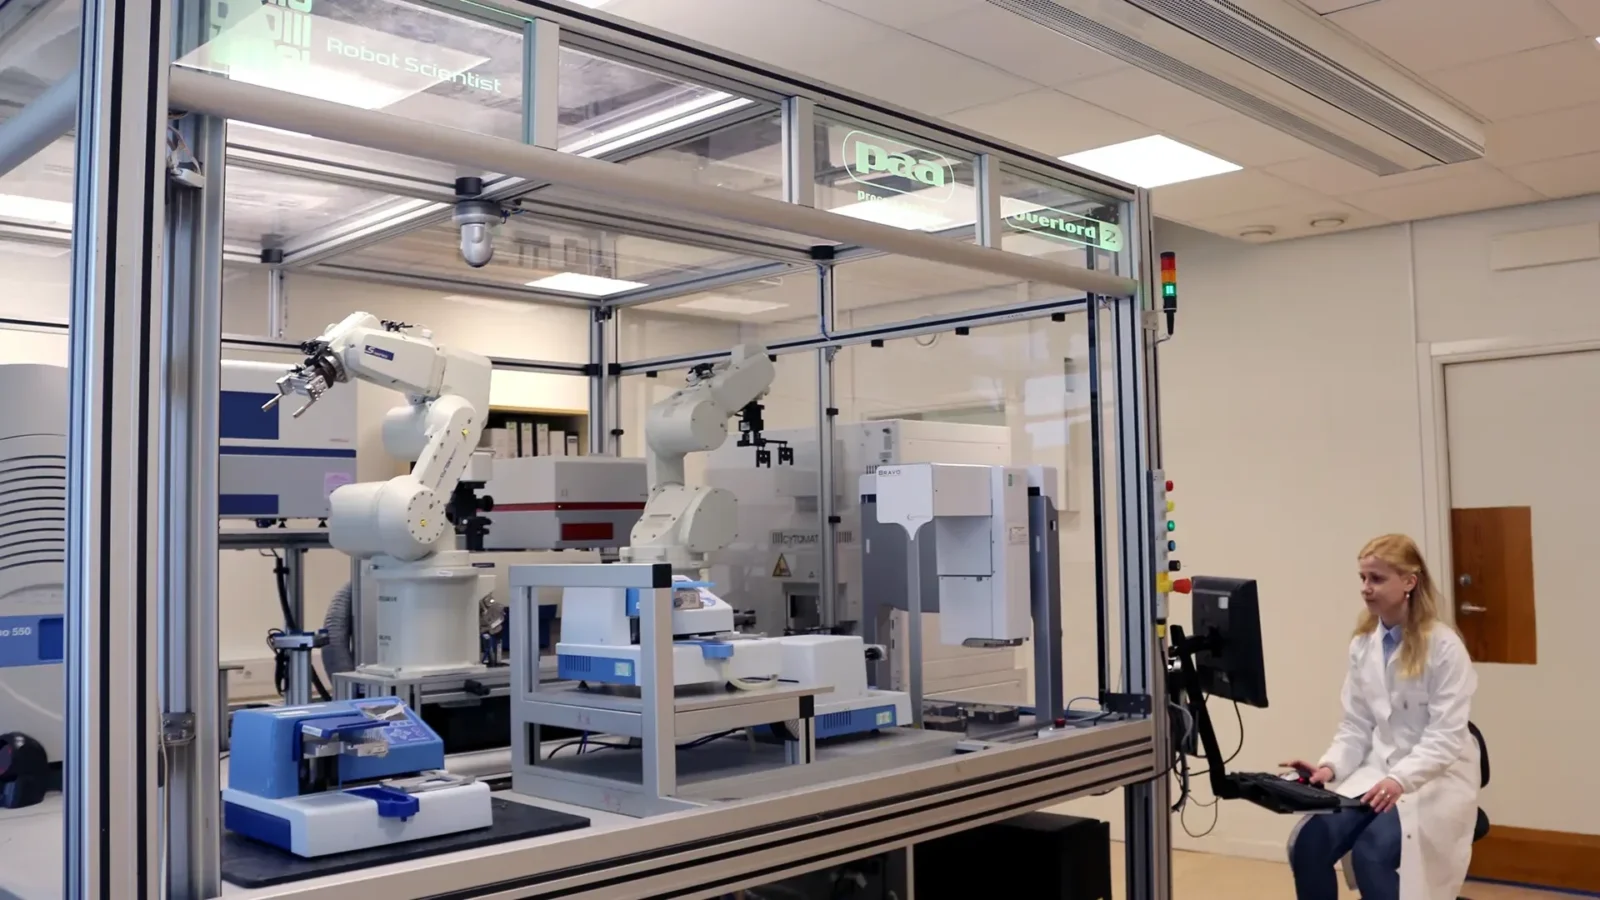
W laboratorium w Göteborgu sztuczna inteligencja przestała ograniczać się do analizowania danych i proponowania pomysłów. Zaczęła sama je testować. Zespół z Chalmers University of Technology opracował zamknięty system, w którym model językowy współpracuje z logiką formalną, bazami biologicznymi i robotami laboratoryjnymi, tworząc cykl odkrywczy od hipotezy aż po weryfikację w probówce.
Badania, opublikowane w „Journal of the Royal Society Interface”, pokazują, jak rozumowanie AI można połączyć bezpośrednio z rzeczywistym eksperymentem, zamiast zatrzymywać się na etapie przewidywań. To jakościowa zmiana w sposobie uprawiania nauki.
Dlaczego samo podłączenie chatbota do sprzętu to zły pomysł
Gdyby badacze po prostu połączyli duży model językowy (LLM) z aparaturą laboratoryjną, ryzyko byłoby ogromne. Modele tego typu potrafią generować niespójne odpowiedzi i twierdzenia bez pokrycia w danych. Gdy oprogramowanie steruje fizycznymi eksperymentami, takie słabości przestają być drobnym mankamentem, a stają się poważnym zagrożeniem.
Dlatego naukowcy z Chalmers zbudowali rozwiązanie hybrydowe. Zamiast pozwalać modelowi swobodnie wnioskować na podstawie literatury, zgromadzili około 60 tysięcy ustrukturyzowanych relacji opisujących fenotypy, fizjologię i metabolizm drożdży. Następnie użyli indukcyjnego programowania logicznego, które wyszukuje wzorce w tych danych i tworzy jawne reguły logiczne, a nie opiera się wyłącznie na nieprzejrzystych reprezentacjach wewnętrznych sieci neuronowej.
Od reguł logicznych do tysięcy hipotez
System wygenerował 735 odrębnych programów logicznych. Po połączeniu ich z pomiarami metabolomicznymi powstało 1933 kandydackie hipotezy dotyczące 16 aminokwasów. Model językowy wkroczył do akcji później – pomagał projektować interwencje eksperymentalne z uwzględnieniem ograniczeń praktycznych, a następnie tłumaczył te plany na instrukcje zrozumiałe dla zautomatyzowanego sprzętu.
„To zbyt dużo informacji, by człowiek mógł je przeanalizować, ale nasz naukowiec AI potrafił wskazać obiecujące pytania biologiczne, zaproponować eksperymenty, ocenić ich wyniki i iteracyjnie doprecyzować rozumienie na podstawie nowych dowodów” – powiedziała badaczka Ievgeniia Tiukova w rozmowie z The Brighter Side of News.
Robot naukowiec Eve i test na drożdżach
Eksperymenty przeprowadzono na Saccharomyces cerevisiae – drożdżach wykorzystywanych w browarnictwie i piekarnictwie, jednym z najlepiej przebadanych organizmów w biologii. Mimo to nawet ten znany mikroorganizm kryje w sobie więcej informacji genetycznych, metabolicznych i fizjologicznych, niż człowiek byłby w stanie systematycznie przeanalizować.
Badacze wybrali hipotezy dotyczące pięciu aminokwasów: glutaminianu, argininy, proliny, glutaminy i lizyny. Zautomatyzowany system sprawdzał, jak suplementacja tych związków wpływa na drożdże poddane różnym stresom chemicznym. Roboty laboratoryjne zajmowały się przenoszeniem cieczy, hodowlą komórek i pobieraniem próbek. Wzrost mierzono w czasie, a spektrometria mas z jonową ruchliwością analizowała profile metaboliczne komórek po zakończeniu eksperymentów.
Nieoczekiwane interakcje chemiczne
Kilka wyników okazało się zaskakujących. Dodanie argininy do drożdży potraktowanych kofeiną wywołało silniejsze zahamowanie wzrostu, niż wynikałoby to z sumy obu czynników osobno. Sama kofeina znacznie ograniczała wzrost, ale zwiększenie stężenia argininy powodowało dodatkowy, synergistyczny spadek.
Glutaminian wywołał inną nieoczekiwaną reakcję – zwiększył wrażliwość komórek na spermę, choć suplementowany glutaminian nie akumulował się wewnątrz komórek tak, jak przewidywano. Sugeruje to, że odpowiedzialny mógł być inny metabolit powstający w dalszym łańcuchu przemian.
Część hipotez się nie potwierdziła. Arginina na przykład nie uratowała komórek przed stresem litowym, wbrew przewidywaniom systemu. Te porażki nie zostały jednak zignorowane – platforma przechowywała zarówno wyniki negatywne, jak i pozytywne, dzięki czemu kolejne hipotezy mogły być weryfikowane względem istniejących dowodów, zanim pochłonęłyby kolejne zasoby.
Gdy prognoza zawodzi, zaczyna się prawdziwe odkrycie
Jeden z eksperymentów pokazał, dlaczego zamknięcie pętli między przewidywaniem a eksperymentem ma tak duże znaczenie. System początkowo sprawdzał, czy glutaminian ochroni drożdże przed stresem wywołanym kwasem mrówkowym. Wynik nie potwierdził zakładanego mechanizmu. Zamiast zakończyć analizę w tym miejscu, badacze wprowadzili nowe dane metabolomiczne z powrotem do potoku obliczeniowego.
Model regresyjny przeszukał powstałe zmiany metaboliczne i uszeregował związki, które mogłyby lepiej wyjaśnić oporność. Wskazał na aminoadypinian – intermediat w metabolizmie lizyny. System wygenerował kolejną hipotezę i skierował ją do ponownego testu.
Gdy aminoadypinian połączono z kwasem mrówkowym, wzrost drożdży poprawił się o około 7 procent na każdy milimol wzrostu stężenia aminoadypinianu. Autorzy opisują to jako pierwszy dowód na to, że aminoadypinian może nadawać oporność na stres wywołany kwasem mrówkowym.
Ten wynik dobrze ilustruje różnicę między konwencjonalną analizą AI a zautomatyzowanym cyklem odkrywczym. Maszyna nie tylko postawiła prognozę. Napotkała sprzeczne dowody, wykorzystała je do sformułowania innego wyjaśnienia i eksperymentalnie przetestowała nowy pomysł.
Każdy eksperyment staje się częścią następnego
Kluczowym elementem projektu było zbudowanie pamięci naukowej, którą maszyny mogłyby odpytywać. Hipotezy, protokoły, prompty LLM, wyniki i metadane eksperymentalne trafiły do bazy grafowej wykorzystującej standardowe ontologie naukowe. Dzięki temu system mógł ustalić, czy pozornie nowe pytanie nie zostało już częściowo rozstrzygnięte przez wcześniejszy eksperyment.
W jednym przypadku AI wygenerowała hipotezę o prolinie i oporności na kwas mrówkowy. Baza danych ujawniła, że istotne pomiary już istnieją, ponieważ prolina była wcześniej używana jako kontrola. Dane te przeczyły nowej hipotezie, co pozwoliło systemowi zdeprecjonować kolejny przebieg laboratoryjny.
Tego rodzaju ponowne wykorzystanie danych może zyskiwać na znaczeniu, jeśli autonomiczne laboratoria zaczną generować tysiące eksperymentów. Fizyczne testy pozostają kosztowne, nawet gdy wykonują je roboty.
Laboratorium wciąż nie jest w pełni samodzielne
System ma istotne ograniczenia. To ludzie określili zakres naukowy, ustalili granice bezpieczeństwa i dostarczyli podstawową architekturę. Konieczna była również fizyczna interwencja przy przenoszeniu płytek próbek między stanowiskami i uzupełnianiu zapasów.
Hipotezy badane dotychczas dotyczyły stosunkowo prostych interakcji chemicznych i metabolicznych w drożdżach. Badanie nie dowodzi, że AI potrafi samodzielnie wybierać ważne problemy badawcze ani interpretować ich szerszego znaczenia naukowego.
Autorzy widzą natomiast przyszłość, w której maszyny przejmują powtarzalne cykle generowania hipotez, eksperymentowania i zarządzania danymi, podczas gdy ludzie decydują, które pytania zasługują na uwagę.
„Naukowcy pozostają niezbędni do określania priorytetów badawczych, interpretowania szerszego znaczenia naukowego i zapewnienia nadzoru etycznego” – powiedział starszy autor badania, Ross King.
Przyszłe wersje systemu mogłyby uwzględniać transkryptomikę, proteomikę i dodatkowe pomiary biologiczne, a bardziej zaawansowane mechanizmy rozumowania wybierałyby eksperymenty, które dostarczą najwięcej nowych informacji.
Znaczenie tego projektu może więc polegać nie tyle na zastępowaniu naukowców, ile na zmianie skali, w jakiej nauka może funkcjonować. Ludzki badacz nie jest w stanie osobiście ocenić tysięcy relacji logicznych, nieprzerwanie prowadzić eksperymentów i przechowywać każdego wyniku w czytelnej dla maszyn sieci wiedzy. Starannie ograniczone autonomiczne laboratorium potencjalnie tak.
Kolejne kroki będą zależeć od tego, jak szybko uda się połączyć bardziej zaawansowane rozumowanie z szerszym zakresem pomiarów biologicznych – i czy uda się zachować bezpieczeństwo, gdy oprogramowanie przejmuje coraz większą kontrolę nad fizycznym sprzętem laboratoryjnym.
Anthropic bada świadomość Claude – religia i etyka
AI samo prowadzi eksperymenty. Przełom w Szwecji
Flux 3 Image: edycja zdjęć bez psucia reszty kadru
GPT-6 Astra złamał 217-letni szyfr Napoleona
Awatar AI Tavus oszukał 48% rozmówców
Yann LeCun: zero obaw o zagładę ludzkości przez AI
AI pokonuje mistrza Stratego. Koniec ludzkiej dominacji?
Ideogram 4.5 rozwiązuje problem edycji obrazów AI
Gemini 4 Argon: Google stawia na cyberbezpieczeństwo
OpenAI i Synopsys łączą siły w projektowaniu chipów
AI rozwiązuje „świętego Graala” teorii prawdopodobieństwa