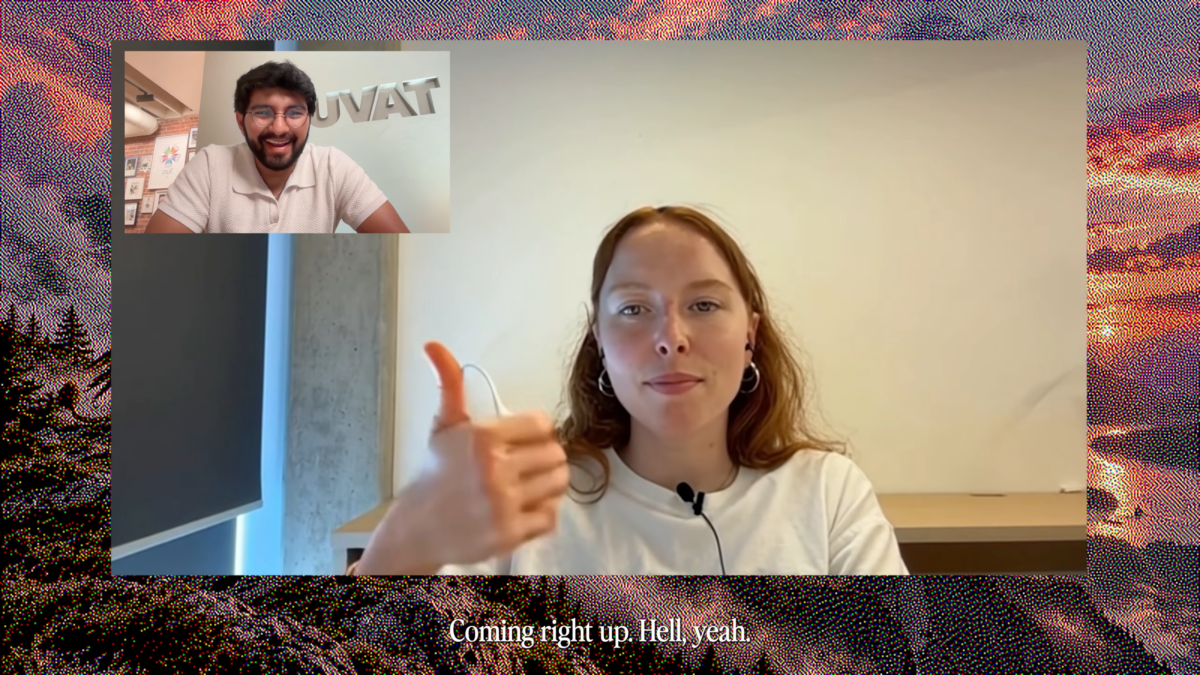
Kalifornijski startup Tavus zaprezentował Griffin – model określany mianem pierwszego „Human Interaction Model” (HIM). To klasa systemów zaprojektowanych do prowadzenia rozmów twarzą w twarz w czasie rzeczywistym, z uwzględnieniem mowy, mimiki, tonu głosu, gestów i pauz. Wyniki badania firmy są zaskakujące: niemal połowa uczestników uznała awatara za prawdziwą osobę.
Jak Griffin radzi sobie z rozmową w czasie rzeczywistym
Griffin nie ogranicza się do generowania odpowiedzi tekstowych. Model jednocześnie odbiera i tworzy przekaz wideo, analizując przy tym sygnały niewerbalne rozmówcy. Oznacza to, że system wychwytuje nie tylko słowa, ale też sposób ich wypowiedzenia – drżenie głosu, zawahanie, wyraz twarzy czy gestykulację.
Takie podejście odróżnia Griffin od wcześniejszych rozwiązań, które koncentrowały się głównie na warstwie językowej. Tavus twierdzi, że jego model jako pierwszy łączy analizę i generowanie wideo w jednym, spójnym procesie.
Wyniki badania: 48% kontra 2%
W badaniu przeprowadzonym przez Tavus 48 procent uczestników po minutowej rozmowie wideo było przekonanych, że rozmawia z człowiekiem. Dla porównania – wcześniejsze systemy osiągały w tym samym teście maksymalnie 2 procent. To skok o ponad dwadzieścia razy.
Firma powołuje się również na niezależny test Nvidii, który mierzył wrażenie „ludzkości” w bezpośredniej rozmowie audio-wideo. Griffin uzyskał 3,83 punktu. Prawdziwi ludzie w tym samym badaniu zdobyli 3,92 punktu, a najlepszy wcześniejszy model AI – 2,80.
Co Tavus planuje zrobić z Griffin
Na razie udostępniono wersję zapowiedziową o nazwie Griffin-Lite, dostępną dla wybranych testerów w ramach „research preview”. Pełniejsza wersja modelu ma pojawić się dopiero po rozwiązaniu kwestii związanych z bezpieczeństwem.
Tavus wskazuje trzy główne obszary zastosowań:
- korepetycje i nauka z wirtualnym nauczycielem,
- ćwiczenie trudnych rozmów, np. rekrutacyjnych czy negocjacyjnych,
- wsparcie techniczne prowadzone przez kamerę.
Firma z San Francisco działa od 2020 roku i pozyskała dotychczas około 64 milionów dolarów finansowania. Zaczynała od spersonalizowanych materiałów wideo dla sprzedaży i marketingu, by następnie rozszerzyć działalność na rozmowy na żywo z cyfrowymi personami. Szczegóły techniczne Griffin opisano w raporcie badawczym Tavus.
Dlaczego to więcej niż kolejny awatar
Granica między syntetycznym obrazem a prawdziwym człowiekiem w rozmowie wideo nigdy nie była tak cienka. Wynik 3,83 punktu w teście Nvidii – przy 3,92 dla ludzi – pokazuje, że różnica staje się statystycznie niewielka. To otwiera pytania nie tylko technologiczne, ale też etyczne i społeczne.
Z jednej strony takie modele mogą realnie wspierać edukację czy trening komunikacji. Z drugiej – rodzą obawy o możliwość podszywania się pod inne osoby, manipulację w rozmowach biznesowych czy dezinformację w wideokonferencjach. Sam Tavus przyznaje, że pełna wersja Griffin czeka na rozwiązanie kwestii bezpieczeństwa, co sugeruje, że twórcy mają świadomość tych zagrożeń.
Na razie Griffin-Lite trafia do ograniczonego grona testerów. Jeśli zapowiedzi się potwierdzą, kolejne miesiące mogą przynieść modele, które w rozmowie wideo będą nieodróżnialne od człowieka dla większości odbiorców. Pytanie brzmi nie „czy”, ale „kiedy” i „z jakimi konsekwencjami”.
GPT-6 Astra złamał 217-letni szyfr Napoleona
Awatar AI Tavus oszukał 48% rozmówców
Yann LeCun: zero obaw o zagładę ludzkości przez AI
AI pokonuje mistrza Stratego. Koniec ludzkiej dominacji?
Ideogram 4.5 rozwiązuje problem edycji obrazów AI
Gemini 4 Argon: Google stawia na cyberbezpieczeństwo
OpenAI i Synopsys łączą siły w projektowaniu chipów
AI rozwiązuje „świętego Graala” teorii prawdopodobieństwa
Google zastępuje Gems Skillami jak Anthropic
Deepseek i Huawei budują alternatywę dla CUDA
GPT-6 Astra: pięciokrotny wzrost ataków w testach