Nvidia udostępniła na licencji otwartej Flora – silnik danych, który automatycznie opisuje nagrania wideo z robotami. Firma przekonuje, że koszt przygotowania godziny materiału spada z około 88 dolarów do 72 centów. To brzmi jak przełom, ale sama Nvidia przyznaje, że wyliczenia są prognozą, a nie wynikiem produkcyjnego wdrożenia.
Kontekst jest istotny. Duże modele AI dla robotów uczą się z filmów, które wymagają opisów tekstowych. Bez nich algorytm nie wie, co właściwie widzi i kiedy dane działanie się kończy. Flora ma ten proces usprawnić i obniżyć jego koszt na tyle, by skalowanie zbiorów treningowych stało się realne.
Dlaczego roboty potrzebują trzech rodzajów etykiet
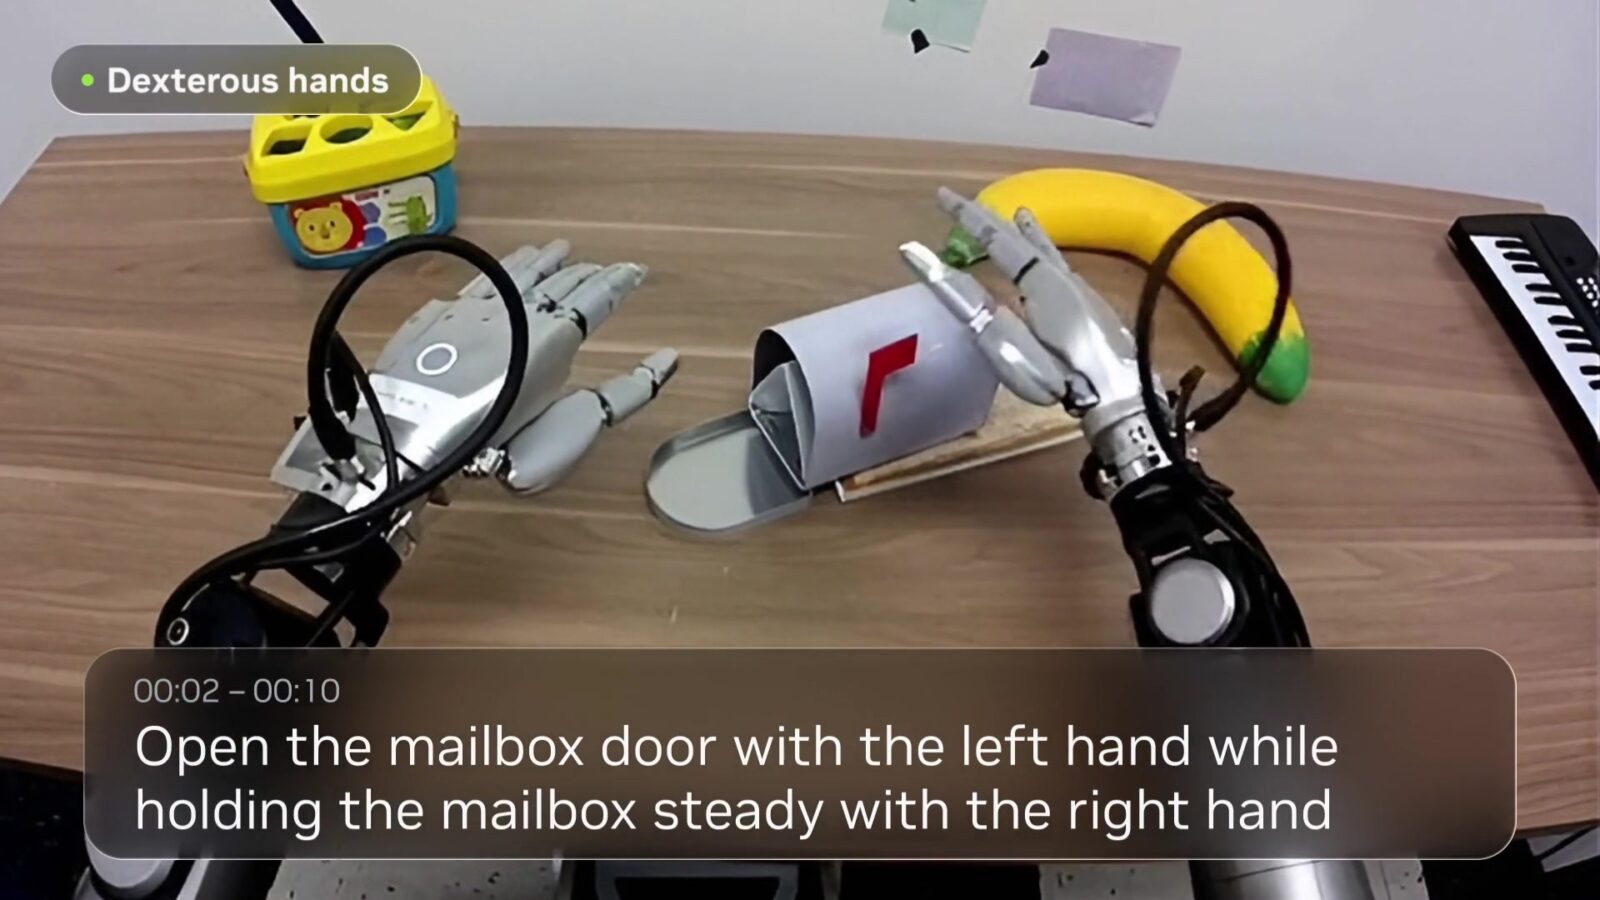
Zespół badawczy GEAR przy Nvidii wskazuje, że do skutecznego treningu potrzebne są trzy typy adnotacji. Pierwszy to opisy akcji z zaznaczeniem, kiedy dokładnie się wydarzają – służą one do wybierania odpowiednich fragmentów nagrania. Drugi obejmuje oceny postępu krok po kroku, dzięki czemu robot może uczyć się metodą prób i błędów. Trzeci to werdykt, czy zadanie zakończyło się sukcesem – wykorzystywany później do monitorowania maszyn w trakcie pracy.
Większość dostępnych narzędzi dostarcza tylko jeden z tych trzech elementów. Duże modele językowe, takie jak GPT-6 Astra, potrafią wygenerować kilka naraz, ale przy ogromnych wolumenach wideo stają się zbyt drogie. Flora została zaprojektowana tak, by dzielić materiał na segmenty czasowe, opisywać każdą akcję oraz oceniać przebieg i wynik całego epizodu.
Jak zbudowany jest system Flora
Za całością stoją trzy modele Qwen3.5 poddane procesowi fine-tuningu (dostrajania do konkretnego zadania). Jeden z nich, o 9 miliardach parametrów, dzieli nagranie na fragmenty odpowiadające poszczególnym działaniom. Większy, 27-miliardowy, opisuje te fragmenty, uwzględniając kontekst – co wydarzyło się przed akcją i po niej.
Flora-Rewarder i potrójna rola oceniającego
Drugi model 27B, nazwany Flora-Rewarder, pełni trzy funkcje w zależności od otrzymanego promptu. Przyznaje ocenę sukcesu w skali od 1 do 5, klasyfikuje każdy półsekundowy krok jako prawidłowy, nieoptymalny lub błędny, a także wystawia punktację według własnych kryteriów. Model segmentacji i model opisujący generują znaczniki czasu, natomiast pojedynczy model nagradzający tworzy wszystkie trzy typy ocen.
System działa już podczas treningu modeli GR00T. Według Nvidii przetwarza do 200 tysięcy godzin nagrań dziennie na 512 układach GB300. Modele są dostępne na Hugging Face.
Wyniki: gdzie Flora wygrywa, a gdzie przegrywa
W teście na 50 filmach Flora uzyskała nieco lepszy wynik niż GPT-6 Astra, mimo że model OpenAI mógł korzystać z pełnych zdolności rozumowania. Przy jakości adnotacji 57,1 procent koszt godziny materiału wyniósł 72 centy, podczas gdy Astra osiągnęła 53,7 procent przy 88,49 dolara. Claude Opus 5 wypadł znacznie słabiej, a i tak kosztował około 42 dolarów za godzinę.
Obraz nie jest jednak jednostronny. Na publicznym benchmarku WGO-Bench Flora najlepiej wykrywa granice akcji, ale w ogólnym wyniku ustępuje Astry i przegrywa z Gemini 3.8 Flash w samej dokładności opisów. Badacze tłumaczą przewagę lepszą lokalizacją czasową. Na własnym zbiorze DenseCaptionBench Flora prowadzi we wszystkich metrykach dla nagrań ludzkich, ale w przypadku filmów robotycznych spada na drugie miejsce.
Pojawia się też zastrzeżenie metodologiczne, które sami autorzy przyznają. GPT-6 Astra ocenia opisy, będąc jednocześnie jednym z testowanych modeli. Flora wygrywa w nagraniach ludzi, ocenie wyników i punktacji krok po kroku, natomiast Astra dominuje na WGO-Bench, w filmach robotów i w ocenianiu według kryteriów.
Wykrywanie błędów w środku epizodu to największa przewaga
Na benchmarku RoboRewardBench odsetek błędów Flory jest o 27,8 procent niższy niż w przypadku Astry. Różnica bierze się z zadań częściowo wykonanych. Gdy robot jedynie przewraca butelkę, zamiast strącić ją ze stołu, Flora przyznaje 3 punkty na 5, zgadzając się z ludzkim odniesieniem, podczas gdy Astra daje tylko jeden.
Flora-Rewarder wychwytuje 53,3 procent nieudanych kroków w obrębie epizodu. Żaden konkurencyjny model nie przekracza 11,7 procent, a Astra nie rozpoznaje ani jednego. Ceną jest odsetek fałszywych alarmów – około 11 procent prawidłowych kroków zostaje oznaczonych jako błąd.
W nagraniu z wieloma krótkimi ruchami dłoni Flora rozpoznała 34 z 37 pojedynczych akcji, podczas gdy Astra tylko cztery. Bywa jednak, że dzieli dłuższe czynności na zbyt wiele drobnych etapów albo myli opisy – w jednym z filmów robot przecierał talerz ściereczką, a system opisał to jako składanie serwetki.
Otwarte narzędzie w strategii Nvidii
Flora ma być alternatywą dla komercyjnych usług, takich jak Physical AI Data Engine od Scale AI. Badacze mogą dzięki niej skalować własne zbiory danych robotycznych i testować podejścia oparte na przenoszeniu ludzkich demonstracji do maszyn.
To element szerszej strategii. Nvidia inwestuje miliardy w otwarte modele AI, by utrzymać deweloperów w swoim ekosystemie sprzętowym i napędzać popyt na własne układy. Firma od dawna łagodzi też niedobór danych treningowych dla robotyki poprzez symulacje i automatyczne przetwarzanie. Podczas tegorocznego GTC pokazała pipeline, który samodzielnie przygotowuje, mnoży i ocenia materiał treningowy. Flora dokłada do niego szczegółowe etykiety i sygnały nagród z wideo.
Nad podobnym obszarem pracuje Google – ogłoszony niedawno Gemini 4 Argon również rozpoznaje etapy pracy w filmach treningowych i oznacza nieudane akcje. Rywalizacja o standaryzację danych dla robotyki dopiero się rozkręca, a otwartość Flory może okazać się argumentem, który przesądzi o jej adopcji w środowisku badawczym.
Nvidia Flora: oznaczanie wideo robotów 125x taniej
Ataki na agenty AI przez pliki AGENTS.md
Jeden agent AI lepszy niż wiele? Anthropic zmienia zasady
Anthropic: samodoskonaląca się AI możliwa już w 2027 roku
AI pomaga juniorom, ale hamuje ich rozwój
Wyciek kluczy API w OpenCode Console – 1,4% użytkowników poszkodowanych
Harnessy agentów AI: droższe, ale nie lepsze
NVIDIA Nemotron 3.5 Bolt: mały model AI do lokalnych agentów
Claude automatycznie dowodzi poprawności kodu
IBM: firmy wybierają tańsze modele open-weight zamiast frontier AI
Audyt w OpenAI ujawnia luki w monitorowaniu AI