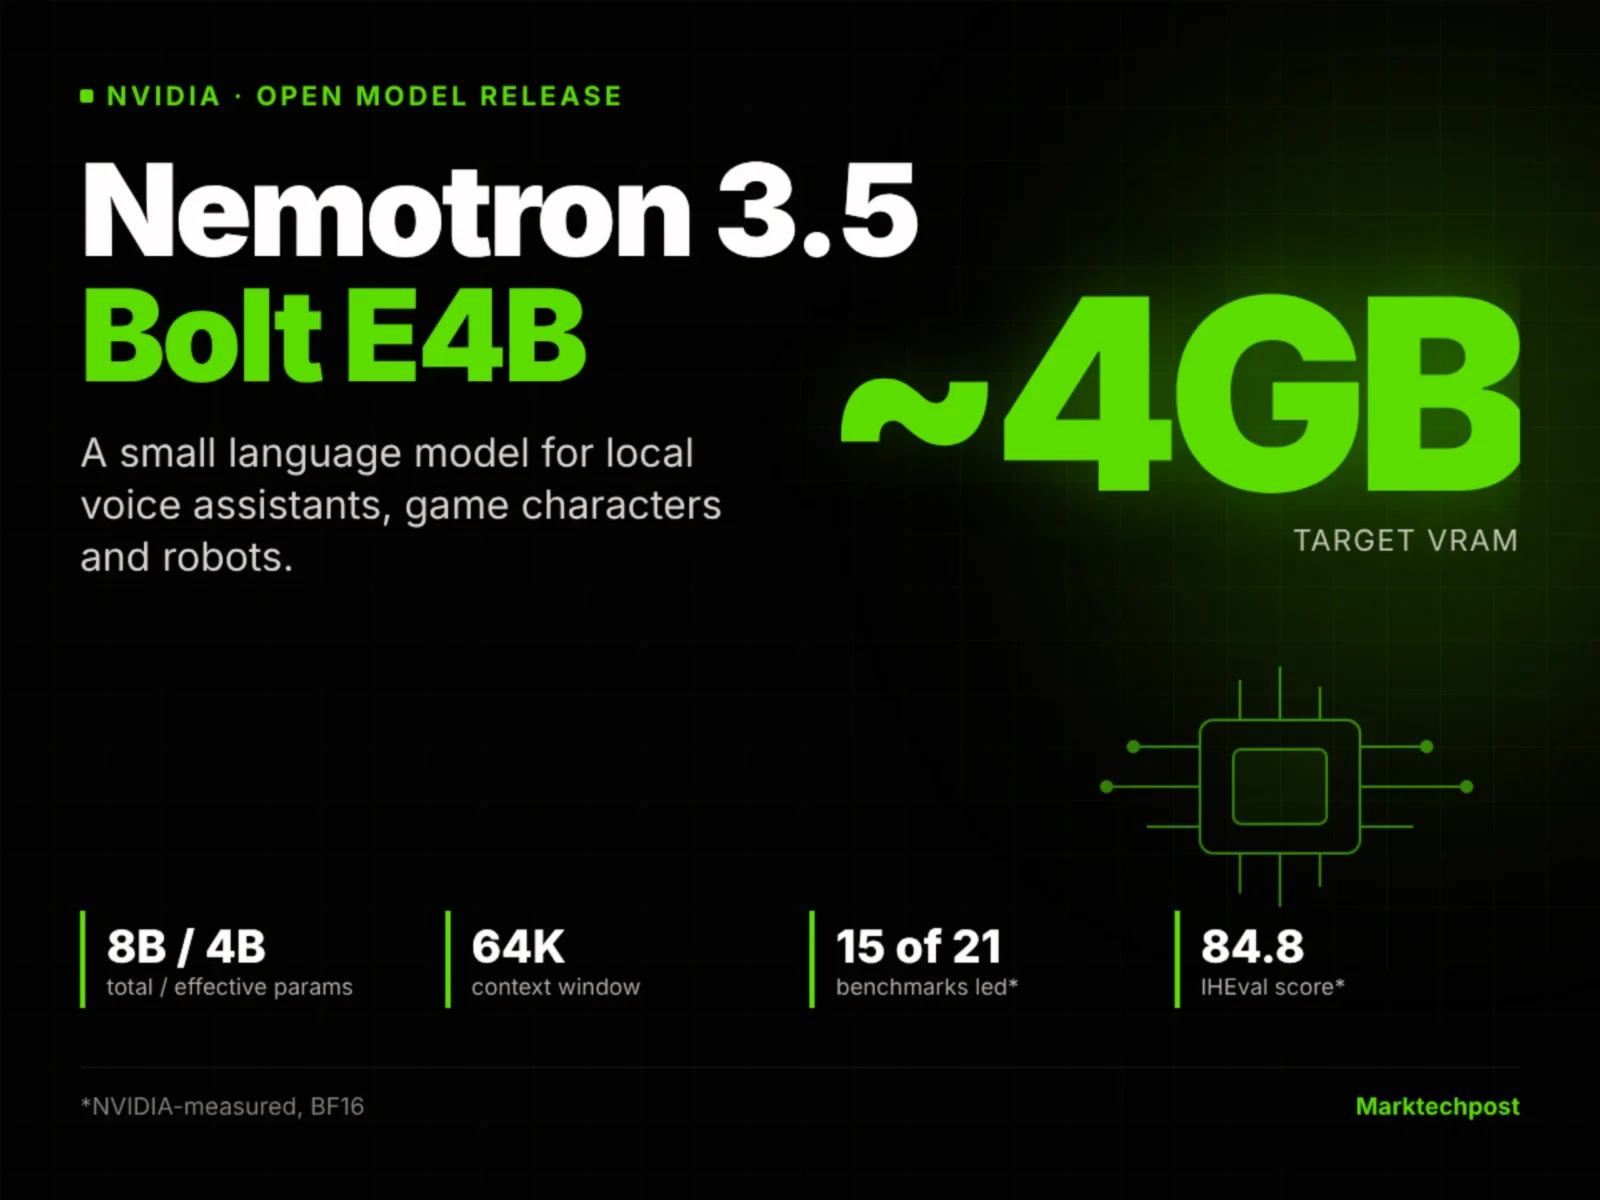
NVIDIA dołączyła do wyścigu małych modeli językowych, publikując Nemotron 3.5 Bolt E4B — otwarty system przeznaczony do szybkich konwersacyjnych agentów działających lokalnie. Model obsługuje asystentów głosowych, postacie niezależne w grach oraz interfejsy robotów, a całość ma mieścić się w okolicach 4 GB pamięci VRAM na sprzęcie RTX, Jetson i Spark. Dla twórców oznacza to, że na jednej karcie zostaje jeszcze miejsce na modele rozpoznawania mowy i analizy obrazu.
Podstawą był Gemma 4 E4B od Google, którą zespół NVIDIA poddał dalszemu treningowi wyłącznie metodą uczenia ze wzmocnieniem. To nietypowe podejście, bo zwykle w takich projektach najpierw stosuje się nadzorowane dostrajanie (SFT), a dopiero potem RL. Tutaj badacze świadomie z niego zrezygnowali.
Co potrafi Nemotron 3.5 Bolt E4B
Model ma 8 miliardów parametrów łącznie, z czego 4 miliardy są aktywne w trakcie inferencji, i obsługuje kontekst o długości 64 tys. tokenów. To wystarcza, by utrzymać historię rozmowy, definicje narzędzi i stan aplikacji w jednym oknie. NVIDIA wymienia trzy główne zastosowania: asystenci urządzeń i głosu, interaktywne postacie oraz agenci wbudowani w systemy przemysłowe.
Rozmowa i wywoływanie narzędzi w jednym
Kluczową funkcją jest wieloetapowe korzystanie z narzędzi z instrukcjami dla wywołań asynchronicznych. Model oferuje też flagę conversational_mode, która wymusza krótkie odpowiedzi gotowe do odczytania na głos, oraz konfigurowalne rozumowanie z limitem budżetu myślenia, pozwalającym kontrolować opóźnienia. W praktyce deweloper może zdecydować, czy agent ma odpowiadać natychmiast, czy poświęcić chwilę na analizę.
Robot, który widzi i mówi
W raporcie badawczym pokazano robota Reachy Mini pracującego na Jetsonie Orin Nano 8GB. W tym układzie model Cosmos 3 Edge odpowiadał za widzenie, a Bolt za odpowiedzi głosowe i wywołania narzędzi. NVIDIA nazywa go również trzecią generacją małego modelu dla postaci z gier w ramach platformy ACE.
Dlaczego zrezygnowano z nadzorowanego dostrajania
Zespół badawczy odkrył, że klasyczne SFT poprawiało wprawdzie zdolność do wywoływania narzędzi, ale psuło jakość rozmowy i zwiększało gadatliwość modelu bazowego. Dlatego trening oparto na RLVR i RLHF z użyciem narzędzi NeMo-RL oraz NeMo-Gym. Każda próbka treningowa przechodziła zarówno w trybie rozumowania, jak i bez niego, w proporcji dwa do jednego na korzyść trybu bez rozumowania. Kary za długość odpowiedzi w środowisku GenRM zapobiegały rozrastaniu się wyników w trakcie uczenia. Datasety i pełna receptura treningu są publicznie dostępne.
Do wdrożenia model skwantyzowano z formatu BF16 do Q4_K_M z kalibracją opartą na macierzy istotności, wykorzystując około miliona tokenów z przebiegów RL. Wydanie zawiera także draft model DFlash do dekodowania spekulatywnego. Na karcie RTX 5070 Bolt z DFlash osiągnął 272,6 tokena na sekundę, podczas gdy Gemma 4 E4B z własnym draftem MTP uzyskała 225,9 tokena na sekundę — przewaga wynosi więc około 1,21 raza.
Wyniki benchmarków: mocne strony i słabości
NVIDIA pogrupowała 21 testów w pięć obszarów kompetencji i zmierzyła je we własnym środowisku NeMo-Gym w precyzji BF16. Bolt prowadził w 15 z 21 przypadków w trybie rozumowania. Producent raportuje też około 40% wyższą średnią punktację niż Nemotron 3 Nano 4B oraz do 80% mniej tokenów wyjściowych w porównaniach z włączonym rozumowaniem. Niezależnie Scale Labs umieściło model na pierwszym miejscu wśród małych systemów w teście MultiChallenge z wynikiem 56,03%.
Nie jest to jednak zwycięstwo we wszystkich kategoriach. Qwen3.5-4B wygrywa w Tau2-Bench (75,1 wobec 55,1), RULER 64K (95,1 wobec 87,0), LongBench v2 (59,9 wobec 50,5) oraz BFCL-v3 (70,9 wobec 68,5). Gemma 4 E4B zachowuje niewielką przewagę w EQ-Bench v3 (41,1 wobec 39,4). Największa luka dotyczy Tau2-Bench, gdzie Bolt traci około 20 punktów — to sygnał, że w złożonych zadaniach agentowych konkurencja wciąż ma przewagę.
Wymagania sprzętowe i dostępność
NVIDIA zmierzyła wersję Q4_K_M w llama.cpp przy batch size 1, z wejściem 3 tys. tokenów i 50 tokenami wyjściowymi. Na RTX 5070 (12 GB) model zużył 3,55 GB VRAM i osiągnął 133,4 tokena na sekundę przy 548 ms do pierwszego tokena. Na RTX Spark (32 GB) było to 3,19 GB i 67 tokenów na sekundę, na Jetsonie AGX Orin (32 GB) — 4,2 GB i 24 tokeny na sekundę, a na Jetsonie Orin Nano (8 GB) — 4,2 GB i 15,5 tokena na sekundę przy 5,8 s do pierwszego tokena.
Warto rozróżnić etykietę „4GB” od rzeczywistego rozmiaru pliku. Oznacza ona docelową kopertę pamięci, nie wagę modelu — plik GGUF w wersji Q4_K_M na Hugging Face waży 6,18 GB. Model jest dostępny na Hugging Face, w Ollama, LM Studio, Unsloth i Jetson AI Lab, a także jako NVIDIA NIM oraz przez In-Game Inferencing SDK. Wagi, dane i receptury opublikowano na licencji OpenMDW-1.1.
Nemotron 3.5 Bolt E4B pokazuje wyraźny kierunek: małe modele przestają być tylko demonstracjami, a stają się elementem lokalnych systemów agentowych, w których liczy się nie tylko wynik w tabeli, ale też opóźnienie, pobór pamięci i możliwość łączenia z modelami percepcji. Otwarte wagi i pełna receptura treningu obniżają barierę wejścia dla zespołów budujących urządzenia i aplikacje. Pytanie brzmi, czy przewaga w benchmarkach agentowych wystarczy, by przekonać deweloperów do porzucenia większych modeli w zadaniach wymagających planowania — czy okaże się, że w tej kategorii wciąż wygrywa rozmiar.
NVIDIA Nemotron 3.5 Bolt: mały model AI do lokalnych agentów
Claude automatycznie dowodzi poprawności kodu
IBM: firmy wybierają tańsze modele open-weight zamiast frontier AI
Audyt w OpenAI ujawnia luki w monitorowaniu AI
Ukraina uderza w centra danych Rosji. Cios dla AI
Anthropic ma model, który bije Mythos 5.1 i jest bezpieczniejszy
Tysiące agentów AI przyspieszyły badania nad chorobą Parkinsona
Red Hat i NVIDIA budują zaporę dla agentów AI
Agent AI zhakował 2250 tenantów Microsoft 365
Vibe coding kontra reklamy w smart TV
Banki w USA blokują agentów AI. Chodzi o bezpieczeństwo