Google AI Edge Gallery – co to jest, jak zainstalować i jakie modele AI uruchomisz offline
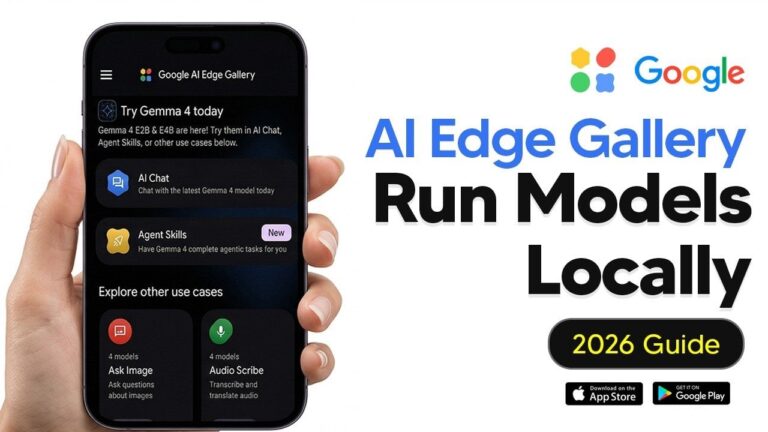
Google AI Edge Gallery to oficjalna, darmowa i otwartoźródłowa aplikacja od Google, która pozwala pobierać oraz uruchamiać modele sztucznej inteligencji bezpośrednio w pamięci smartfona, całkowicie bez internetu. W praktyce oznacza to, że możesz rozmawiać z czatbotem, analizować zdjęcia, transkrybować nagrania głosowe i przeszukiwać wideo w trybie samolotowym, bez wysyłania danych do chmury. Program działa na systemach Android (12+) oraz iOS (17+), a wydanie v1.0.20 (stan na październik 2026) obsługuje m.in. modele Gemma 4 i EmbeddingGemma 2.
Co to jest Google AI Edge Gallery i po co powstała ta aplikacja?
Aplikacja jest poligonem testowym (sandboxem) stworzonym przez zespoły Google AI Edge oraz Android ML Team i rozwijanym na licencji Apache 2.0. Projekt zebrał w oficjalnym repozytorium na GitHubie około 25 tysięcy gwiazdek i ma status eksperymentalnej wersji Beta (stan na październik 2026). Podczas gdy inne darmowe narzędzia AI od Google wymagają połączenia z chmurą, ten program przenosi obliczenia na procesor (CPU), układ graficzny (GPU) lub koprocesor neuronowy (NPU) telefonu.
- Dla użytkowników dbających o prywatność: to darmowe narzędzie bez reklam, subskrypcji i limitów tokenów, działające w samolocie i poza zasięgiem sieci przy pracy z poufnymi danymi.
- Dla programistów mobilnych: to wzorcowa implementacja pokazująca, jak wdrażać lokalne modele
.litertlm(silnik LiteRT-LM, dawniej TensorFlow Lite) oraz potoki MediaPipe (.task,UniversalEmbedder,SemanticRetriever) i jak mierzyć ich wydajność na konkretnym układzie SoC.
Jak zainstalować Google AI Edge Gallery na Androidzie i iPhonie (sklep oraz APK)?
Instalacja zajmuje kilka minut, a program pobierzesz bezpłatnie ze sklepów mobilnych lub jako plik instalacyjny z GitHuba (stan na październik 2026, wersja v1.0.20 z 6 października 2026 r.).
- Wybierz źródło instalacji dla swojego urządzenia:
- Android (12 lub nowszy): zainstaluj aplikację ze sklepu Google Play (com.google.ai.edge.gallery).
- iPhone (iOS 17 lub nowszy): pobierz program z Apple App Store.
- Instalacja z pliku APK: jeśli wpisujesz w wyszukiwarkę google ai edge gallery apk pobierz, pobieraj plik wyłącznie z oficjalnego repozytorium GitHub google-ai-edge/gallery (zakładka Releases). Przed ręczną aktualizacją z wcześniejszej wersji APK najpierw odinstaluj starą aplikację, aby uniknąć błędów pakietu i konfliktów bazy danych.
- macOS (eksperymentalnie): na komputerach Mac dostępny jest instalator
GoogleAIEdgeGallery-0.1.0.dmgpozwalający testować większe modele lokalne.
- Dobierz wariant APK (przy instalacji z GitHuba): w wydaniu v1.0.20 oprócz wersji uniwersalnej (
ai-edge-gallery.apk) dostępne są osobne pliki APK pod wybrane procesory Snapdragon (sm8550,sm8650,sm8750,sm8850) oraz Google Tensor (tensor-g5,tensor-g6), prawdopodobnie z akceleracją NPU. Na pozostałych urządzeniach zainstaluj zwykły plikai-edge-gallery.apk. - Pobierz model przez Wi-Fi: otwórz wybrane zadanie (np. „AI Chat” lub „Ask Image”) i pobierz model (od 30,5 MB do 4,92 GB). Modele na licencji Apache 2.0 (Gemma 4, EmbeddingGemma 2, Qwen 2.5, DeepSeek R1 Distill) pobierają się od razu, a licencje modeli chronionych (np. Gemma 3n) zaakceptujesz na koncie Hugging Face wewnątrz aplikacji.
- Załaduj własny model (opcjonalnie): wskaż plik
.litertlmz pamięci telefonu lub wklej adres URL karty modelu z Hugging Face.

Film: AI offline na smartfonie – lokalne modele bez internetu, po polsku. Autor: kanał Miliony Monet (YouTube, czerwiec 2026).
Jakie modele uruchomisz i ile ważą – Gemma na telefonie i inne modele offline
Oficjalna lista dla wersji 1.0.20 obejmuje 11 modeli skwantyzowanych do 4 lub 8 bitów (stan na październik 2026). Dzięki temu gemma na telefonie działa obok modeli Qwen oraz DeepSeek, obsługując czat, multimedia i akcje systemowe.
| Nazwa modelu | Rozmiar | Min. RAM | Kontekst / Max | Moduły | Zastosowanie |
|---|---|---|---|---|---|
| Gemma-4-E2B-it | 2,59 GB | 8 GB | 32 000 / 4 000 | AI Chat, Prompt Lab, Agent Skills, Ask Image, Audio Scribe | Kompaktowy model multimodalny (Apache 2.0) z Thinking Mode, Speculative Decoding i MTP. |
| Gemma-4-E4B-it | 3,66 GB | 12 GB | 32 000 / 4 000 | AI Chat, Prompt Lab, Agent Skills, Ask Image, Audio Scribe | Dokładniejszy wariant Gemma 4 (Effective 4B) z pełną multimodalnością i Agent Skills. |
| EmbeddingGemma-2 (740M) | 484,6 MB | ok. 200-600 MB | wektorowy | Instant Media Search, Video Moment Finder | Nowość v1.0.20: mapuje tekst, zdjęcia, wideo i audio do wspólnej przestrzeni wektorowej. |
| Gemma-3n-E2B-it (int4) | 3,66 GB (Android) / 3,39 GB (iOS) | 8 GB / 6 GB (iOS) | 4 096 | AI Chat, Prompt Lab, Ask Image, Audio Scribe | Model MatFormer zoptymalizowany pod niskie zużycie zasobów na mobilnym CPU. |
| Gemma-3n-E4B-it (int4) | 4,92 GB (Android) / 4,65 GB (iOS) | 12 GB / 8 GB (iOS) | 4 096 | AI Chat, Prompt Lab, Ask Image, Audio Scribe | Większy wariant Gemma 3n z obsługą obrazu i audio, szybki na CPU (kontekst 4K). |
| Gemma3-1B-IT (int4) | 584,4 MB | 6 GB / 4 GB (iOS) | 1 024 | AI Chat, Prompt Lab | Ultralekki model tekstowy na starsze telefony (na iOS działa od 4 GB RAM). |
| Qwen2.5-1.5B-Instruct (q8) | 1,60 GB | 6 GB | 4 096 | AI Chat, Prompt Lab | Model tekstowy 1,5B (8-bit), sprawny w instrukcjach i wielu językach. |
| DeepSeek-R1-Distill-Qwen-1.5B | 1,83 GB | 6 GB | 4 096 | AI Chat, Prompt Lab | Destylowany model rozumowania (reasoning) do logiki, kodu i matematyki. |
| TinyGarden-270M | 289,0 MB | 6 GB | 1 024 | Tiny Garden | Mikro-model FunctionGemma 270M sterujący minigrą ogrodniczą głosem lub tekstem. |
| MobileActions-270M | 289,0 MB | 6 GB | 1 024 | Mobile Actions | Mikro-model FunctionGemma 270M przekładający komendy na offline’owe akcje telefonu. |
| Magic touch | 30,5 MB | brak limitu | wizyjny | Scrapbook | Model MediaPipe wycinający obiekty ze zdjęć po dotknięciu ekranu. |
Największe możliwości dają modele Gemma 4 działające lokalnie offline. Choć pełna architektura Gemma 4 obsługuje 128 000 tokenów kontekstu, w plikach .litertlm dla Google AI Edge Gallery limit maxContextLength zmniejszono do 32 000 tokenów (ok. 40-50 stron tekstu), co chroni telefon przed przepełnieniem pamięci RAM przez bufor KV Cache. Na iOS bazowa lista obejmuje modele Gemma 3n i Gemma 3 1B (od 4 GB RAM) oraz dodane w aktualizacjach wsparcie dla Gemma 4 i EmbeddingGemma 2.
Co potrafi AI Edge Gallery: funkcje aplikacji i gotowe prompty
Program dzieli funkcje na dziesięć modułów, które przetwarzają tekst, zdjęcia, dźwięk i wideo bez chmury (stan na październik 2026):
- „AI Chat” z „Thinking Mode” i MTP: czat konwersacyjny z zapisem sesji oraz obsługą zdjęć i audio w oknie rozmowy. Dla Gemma 4 włączysz tryb rozumowania („Thinking Mode”) oraz opcje „Multi Token Prediction” (MTP) i „Speculative Decoding” przyspieszające pisanie.
- „Agent Skills”: zmienia Gemma 4 w asystenta korzystającego z widżetów WebView/JS i protokołu MCP. W repozytorium projektu znajdziesz wbudowane umiejętności, m.in.
query-wikipedia,interactive-map,kitchen-adventure,mood-tracker,qr-code,send-email,calculate-hashitext-spinner, oraz dodatkowe z katalogu (np.virtual-piano). - „Instant Media Search” i „Video Moment Finder” (v1.0.20): moduły napędzane przez wielomodalny model EmbeddingGemma 2. Pierwszy przeszukuje galerię zdjęć w czasie rzeczywistym (search-as-you-type) po opisie lub obrazie z kamery. Drugi indeksuje obraz i dźwięk w pliku wideo (bez wcześniejszej transkrypcji mowy na tekst) i zaznacza na osi czasu szukany moment, np. „pies łapiący frisbee”.
- „Ask Image” i „Audio Scribe”: odczyt dokumentów OCR (paragony, faktury, zadania matematyczne) ze zdjęć oraz transkrypcja i tłumaczenie nagrań głosowych offline.
- „Prompt Lab”, „Scrapbook”, „Mobile Actions” i „Tiny Garden”: testowanie pojedynczych instrukcji z regulacją parametrów (
temperature,topK,topP,CPU/GPU), wycinanie obiektów ze zdjęć (Magic touch) oraz sterowanie telefonem i minigrą za pomocą mikro-modeli FunctionGemma 270M.
Skopiuj i przetestuj 4 gotowe prompty w odpowiednich modułach aplikacji:
1. „Ask Image” – analiza paragonu: otrzymasz tabelę wydatków i kontrolę sumy bez wysyłania zdjęcia do sieci. Zmień [waluta] oraz [kategorie].
Odczytaj wszystkie pozycje ze zdjęcia paragonu. Wypisz je jako listę: nazwa produktu, cena w [waluta] oraz kategoria: [kategorie, np. spożywcze, chemia, inne]. Na końcu podaj kwotę łączną i sprawdź, czy suma pozycji się zgadza.2. „AI Chat” z „Thinking Mode” (Gemma-4-E2B-it / E4B-it): dostaniesz plan działania z analizą ryzyka. Uzupełnij [cel] oraz [czas i budżet].
Rozpisz plan realizacji zadania: [cel, np. konfiguracja domowego serwera NAS]. Ograniczenia: [czas i budżet, np. 1 weekend, do 1500 zł]. Podziel plan na kroki, wskaż 3 najczęstsze błędy techniczne i napisz, jak ich uniknąć.3. „Prompt Lab” (ustaw temperature = 0.2): przekształcisz luźne punkty w gotowy e-mail. Podmień [odbiorca] i wklej tekst w [surowa notatka].
Przekształć poniższą notatkę w rzeczowy e-mail do: [odbiorca, np. klienta czekającego na wycenę]. Zachowaj liczby i terminy, usuń powtórzenia, a na końcu wypunktuj 2 pytania wymagające decyzji. Notatka: [surowa notatka]4. „AI Chat” (Gemma-4-E4B-it): wygenerujesz fiszki do nauki offline. Zmień [zagadnienie] oraz [poziom].
Przygotuj 5 fiszek edukacyjnych (pytanie i odpowiedź) na temat: [zagadnienie, np. zapytania SQL typu JOIN] dla osoby na poziomie: [poziom, np. początkujący analityk]. Dodaj po jednym przykładzie.Wymagania sprzętowe i wydajność: jak działa lokalne AI na telefonie?
Aby uruchomić lokalne AI na telefonie, potrzebujesz smartfona z minimum 6 GB RAM na Androidzie (12+) lub 4-6 GB RAM na iPhonie (iOS 17+) oraz od 650 MB do 5 GB wolnego miejsca (stan na październik 2026). Klikając przycisk „Stats” pod odpowiedzią w Google AI Edge Gallery, sprawdzisz czas do pierwszego tokena (TTFT), prędkość czytania promptu (Prefill Speed) i prędkość pisania (Decode Speed).
- CPU vs GPU: na samym procesorze (CPU) modele działają wolniej, a Gemma 4 z szerszym kontekstem (32 tys. tokenów) zwalnia najbardziej. Przełączenie na układ GPU i włączenie funkcji MTP wyraźnie przyspiesza odpowiedzi. Dokładne wartości na swoim telefonie sprawdzisz przyciskiem „Stats”.
- Telefony budżetowe (6 GB RAM): oficjalnie
Gemma-4-E2B-itwymaga 8 GB RAM, aGemma-4-E4B-it12 GB RAM. Na telefonach z 6 GB RAM wybieraj lżejsze modele z listy (np.Qwen2.5-1.5B-Instruct,Gemma3-1B-IT). Pierwsze załadowanie modelu może trwać do minuty. - Snapdragon i Tensor: dla wybranych układów Qualcomm Snapdragon i Google Tensor projekt udostępnia osobne pliki APK, które mogą lepiej wykorzystać sprzętowe przyspieszenie. Jeśli budujesz podobne środowisko stacjonarnie, zobacz, jak działa asystent AI offline na Raspberry Pi 5.
Czy Edge Gallery Google działa po polsku i jak radzi sobie z polszczyzną?
Tak, modele dostępne w programie komunikują się po polsku, mimo że sam interfejs Edge Gallery Google (nazwy zakładek i ustawień) jest obecnie anglojęzyczny (stan na październik 2026). Po menu poruszasz się po angielsku, ale prompty, rozmowy i zdjęcia z polskimi napisami przetwarzasz po polsku.
Modele Gemma 4 oraz Gemma 3n obsługują ponad 140 języków. Warianty Gemma-4-E2B-it, Gemma-4-E4B-it i Qwen2.5-1.5B-Instruct poprawnie piszą polskie e-maile, streszczają artykuły i odczytują polskie paragony w „Ask Image”. Również EmbeddingGemma-2 przyjmuje polskie opisy podczas szukania zdjęć i scen wideo. Jedynie w najmniejszym modelu Gemma3-1B-IT (584 MB) zdarzają się kalki językowe i błędy odmiany, dlatego do języka polskiego wybieraj modele od 1,5B wzwyż.
Prywatność i ograniczenia: co zostaje na telefonie w Google AI Edge Gallery?
Po pobraniu modelu całe przetwarzanie odbywa się w 100% lokalnie na smartfonie. Twoje prompty, zdjęcia z „Ask Image”, nagrania w „Audio Scribe” i indeksowane filmy nie opuszczają urządzenia, a wektory wyszukiwania dla galerii trafiają do lokalnej bazy SQLite (zero cloud roundtrips). W wersji 1.0.19 usunięto też z AndroidManifest.xml szerokie uprawnienia do pamięci na rzecz bezpiecznego systemowego selektora pojedynczych plików. Do pracy z dużymi zbiorami poufnych plików na komputerze przetestuj AnythingLLM do prywatnego czatu z dokumentami.
Aplikacja łączy się z siecią wyłącznie w trzech sytuacjach: podczas pobierania lub aktualizacji modeli, po ręcznym wywołaniu umiejętności internetowej w „Agent Skills” (np. query-wikipedia) oraz przy dobrowolnym wysłaniu opinii przez „Feedback Collector”. Pamiętaj jednak o trzech ograniczeniach fizycznych smartfonów: dłuższa praca z modelami 3-4 GB nagrzewa obudowę i zużywa baterię, wariant E4B potrafi zamknąć aplikacje w tle z braku RAM-u, a mniejsze modele offline nie znają bieżących wiadomości z sieci – w takich zadaniach lepiej sprawdzą się chmurowe narzędzia AI od Google.
Najczęściej zadawane pytania (FAQ)
0 zł – aplikacja jest w pełni darmowa, pozbawiona reklam, mikropłatności i opłat za tokeny (stan na październik 2026). Kod programu oraz modele Gemma 4 są udostępniane na otwartej licencji Apache 2.0.
Wyłącznie z zakładki Releases w oficjalnym repozytorium GitHub google-ai-edge/gallery lub bezpośrednio ze sklepu Google Play. Znajdziesz tam uniwersalny plik ai-edge-gallery.apk oraz warianty pod wybrane układy Snapdragon i Tensor. Przed ręczną aktualizacją APK odinstaluj starszą wersję aplikacji.
Tak, po pobraniu wybranego modelu do pamięci smartfona wszystkie główne moduły (czat, analiza zdjęć, transkrypcja audio i wyszukiwanie wideo) działają w 100% offline w trybie samolotowym. Internet jest potrzebny jedynie do pobrania wag modelu (30,5 MB – 4,92 GB) lub odpytania Wikipedii w module Agent Skills.
Gemma-4-E2B-it (2,59 GB) to najlepszy wybór na telefony z 8 GB RAM, bo obsługuje tekst, obraz, audio, Thinking Mode i Agent Skills. Na starsze smartfony z 6 GB RAM do zadań tekstowych wybierz Qwen2.5-1.5B-Instruct (1,60 GB) lub DeepSeek-R1-Distill-Qwen-1.5B (1,83 GB), a na iPhone’a z 4 GB RAM pobierz Gemma3-1B-IT (584,4 MB).
Tak, dostępna jest eksperymentalna wersja desktopowa na system macOS w formie instalatora GoogleAIEdgeGallery-0.1.0.dmg (stan na październik 2026). Pozwala ona testować na komputerach Mac większe modele lokalne.
Dalej w tym temacie

AnythingLLM – co to jest, instalacja i prywatny czat z dokumentami PDF lokalnie
AnythingLLM konsoliduje w jednym, samodzielnie hostowanym środowisku możliwości Ollamy, LangChain i własnych interfejsów. To odpowiedź na fragmentację narzędzi dla develo…
Poradnik13 min czytania
AMD Ryzen AI Pro i 128GB RAM: Twój laptop to teraz prywatne AI
Czy Twój laptop może działać jak prywatne centrum AI bez dostępu do internetu? Testy pokazują, że połączenie procesora AMD Ryzen AI Pro z 128 GB pamięci RAM to rewolucja.…
Poradnik4 min czytania
Gemma 4: AI Google działające lokalnie na twoim laptopie
Google Gemma 4 przenosi zaawansowaną sztuczną inteligencję bezpośrednio na twój laptop, bez konieczności łączenia z chmurą. Dzięki wariantom dopasowanym do sprzętu, od Ra…
Open source i modele lokalne4 min czytania15 kwietnia 2026