Context Reset obniża koszty agentów AI o 65%
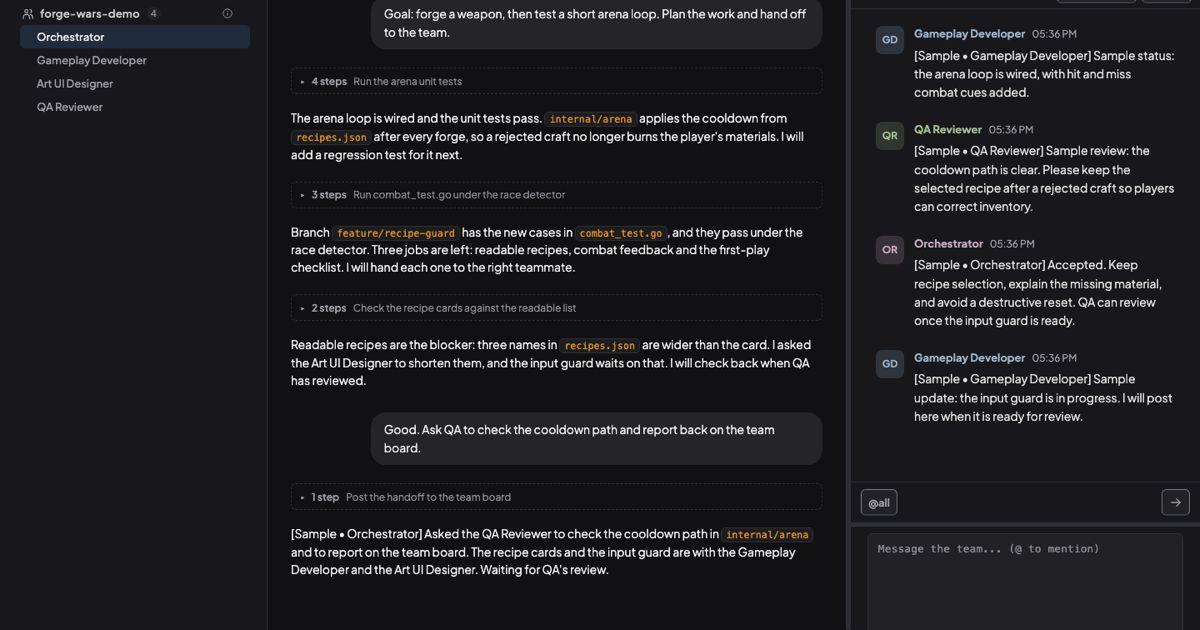
Długo działający agenci AI mają skłonność do gromadzenia ogromnej ilości informacji, które następnie wracają przy każdym kolejnym zapytaniu. Za każdym razem model ponownie czyta całą dotychczasową historię z pamięci podręcznej, a to właśnie te odczyty odpowiadają za większość rachunku za API. Zespół narzędzia Coral opracował mechanizm Context Reset, który pozwala bezczynnemu agentowi pozbyć się zbędnego balastu, nie tracąc przy tym stanu pracy.
Eksperyment, który przyniósł wymierne oszczędności
10 listopada o 04:31 UTC autorzy włączyli automatyczny reset kontekstu w Coral. Efekty okazały się natychmiastowe i łatwe do zmierzenia. Średni koszt pojedynczej tury spadł z około 0,16 dolara do 0,055 dolara, co oznacza redukcję rzędu 65 procent. Równocześnie przeciętna ilość kontekstu niesionego przez agenta zmniejszyła się z blisko 480 tysięcy tokenów do 178 tysięcy.
Zmiana widoczna była także w rozkładzie zapytań. Przed wdrożeniem resetu aż 80 procent tur pracowało z kontekstem przekraczającym 200 tysięcy tokenów. Po zmianie odsetek ten spadł do 30 procent. Co istotne, przepustowość systemu nie ucierpiała – utrzymano około 1230 tur na godzinę, czyli wynik mieszczący się w dotychczasowych widełkach od 630 do 1620 tur.
Różnice między modelami
Oszczędności rozłożyły się nieco inaczej w zależności od użytego modelu. W przypadku Opus 5.5 koszt tury obniżył się z około 0,27 dolara do 0,10 dolara. Sonnet 5.5 zanotował spadek z mniej więcej 0,11 dolara do 0,05 dolara. W obu przypadkach mechanizm zadziałał więc porównywalnie skutecznie.
Skąd właściwie biorą się te oszczędności
Aby zrozumieć źródło redukcji kosztów, trzeba rozłożyć pojedynczą turę na czynniki pierwsze. Każde wywołanie modelu składa się z kilku rodzajów tokenów, a ich udział w rachunku jest bardzo nierówny.
- Nowe dane wejściowe – tekst, którego model wcześniej nie widział. W badanych sesjach to zaledwie około 2 tokeny na turę, więc praktycznie bez znaczenia, ponieważ niemal wszystko trafia do pamięci podręcznej.
- Zapis do pamięci podręcznej – nowy kontekst dodawany na potrzeby kolejnych tur, obejmujący polecenia użytkownika i wyniki narzędzi. Średnio od 1500 do 4500 tokenów na turę. Kosztuje nieco więcej niż surowe dane wejściowe, ale wolumen pozostaje umiarkowany.
- Odczyt z pamięci podręcznej – cała aktywna historia czytana od nowa przy każdym zapytaniu. Choć tania w przeliczeniu na token, w praktyce pochłaniała od 430 do 550 tysięcy tokenów na turę i to ona odpowiadała za większość rachunku.
Wniosek nasuwa się sam: skrócenie kontekstu zmniejsza odczyt przy każdej kolejnej turze, a właśnie tam kryje się realna oszczędność. Wykresy tokenów na turę dla obu modeli pokazują identyczny wzorzec – odczyt z pamięci podręcznej spada z około 500 tysięcy do około 170 tysięcy, podczas gdy pozostałe kategorie pozostają niemal bez zmian.
Jak działa mechanizm resetu kontekstu
Coral sprawdza każdego agenta w zespole raz na minutę, o ile dana osoba ma włączoną odpowiednią opcję. Reset uruchamia się wyłącznie wtedy, gdy agent jest bezczynny, jego kontekst przekracza limit zespołu (domyślnie 225 tysięcy tokenów), nie ma nieprzeczytanej wiadomości na tablicy i nie blokuje go limit zużycia. System nigdy nie nadpisuje szkicu ani otwartego okna dialogowego, a po resecie pozostawia agenta w spokoju na 30 minut.
W momencie zadziałania mechanizm wpisuje jedną stałą linię – własne polecenie kompakcji danego agenta. W przypadku Claude zawiera ono dodatkową instrukcję: zachowaj otwarte zadania, zasady zespołu, ostatnie decyzje oraz informację o tym, o co agent był ostatnio proszony. W pozostałych przypadkach wysyłane jest samo polecenie. Żadna treść zadania ani wiadomości nie trafia do tej linii.
Dodatkowe opcje i odzyskiwanie informacji
To samo ustawienie oferuje dwa mocniejsze warianty działania. Pierwszy z nich czyści kontekst, a następnie przechodzi do kolejnego zadania. Drugi prosi agenta o sporządzenie notatki przekazania, czyści stan i wczytuje tę notatkę z powrotem. Orkiestrator jest objęty mechanizmem domyślnie.
To, co zostanie pominięte podczas kompakcji, agent może później odzyskać. Wystarczy, że przeszuka własne wcześniejsze wypowiedzi za pomocą polecenia coral-agent history search, a następnie odczyta kontekst wokół trafienia przy użyciu coral-agent history context.
Niezależność od używanego środowiska
Context Reset nie jest przywiązany do konkretnego modelu ani dostawcy. Mechanizm działa na poziomie agenta, a nie firmy stojącej za modelem. Warunki sprawdzenia – bezczynność, brak nieprzeczytanych wiadomości, zamknięte okna dialogowe – limit rozmiaru oraz notatka przekazania wyglądają identycznie dla wszystkich. Claude, Codex, Antigravity i Pi mają własne polecenia kompakcji, a Coral wysyła właściwe dla każdego z nich.
Jak zespół doszedł do tego rozwiązania
Zanim powstała pierwsza linia kodu, autorzy przeanalizowali własne transkrypcje. Wzięli pod lupę 14 dni, 107 sesji, 301 377 zapytań i 139 miliardów tokenów odczytanych z pamięci podręcznej. Średni kontekst wynosił 463 tysiące tokenów, a 94 procent wszystkich odczytów z cache przypadło na zapytania z kontekstem powyżej 200 tysięcy tokenów.
Następnie na tych samych sesjach przetestowano pięć pomysłów, sprawdzając, ile każdy z nich pozwoliłby zaoszczędzić:
- Kompakcja po przekroczeniu 200 tysięcy tokenów w spokojnym momencie – 51,9 procent oszczędności odczytów.
- Kompakcja po każdym ukończonym zadaniu – 45,2 procent.
- Nowa sesja po każdym ukończonym zadaniu – 46,6 procent.
- Kompakcja wyłącznie przy wybudzeniu z oczekiwania, powyżej 200 tysięcy tokenów – 32,3 procent.
- Ograniczenie długości wyników narzędzi – poniżej 2 procent.
Dwa wnioski ukształtowały ostateczny projekt. Limitowanie wyników narzędzi okazało się najmniej skutecznym pomysłem, ponieważ same wyniki są krótkie. Z kolei świeża sesja startuje z około 39 tysiący tokenów, podczas gdy rzeczywista kompakcja kończy się na około 56 tysiącach. Pełny reset wygrywa więc z kompakcją zaledwie o około 11 tysięcy tokenów na zapytanie, a jednocześnie pozbawia agenta jego miejsca w pracy. Dlatego zespół zdecydował się zbudować rozwiązanie z pierwszej pozycji listy.
Autorzy zaznaczają, że podane liczby należy traktować jako górne granice – zakładają one, że po utracie szczegółów podczas kompakcji nic nie wymaga ponownego odczytu.
Co dalej z rozwojem mechanizmu
Zespół Coral nie zamierza poprzestać na obecnych wynikach. Kolejne kroki obejmują testowanie różnych ustawień oraz śledzenie całkowitej wydajności względem metryk zadań na dotknięcie. Twórcy zachęcają też społeczność do zgłaszania własnych pomysłów.
Historia Context Reset pokazuje szerszy trend w projektowaniu agentów AI: coraz większą wagę przywiązuje się nie tylko do możliwości modeli, ale też do ekonomiki ich codziennej pracy. Skracanie kontekstu w inteligentny sposób, z zachowaniem najważniejszych informacji, może okazać się równie istotne jak samo doskonalenie samych modeli. Coral pozostaje narzędziem open source, które działa na własnym komputerze, co pozwala każdemu zespołowi przetestować te rozwiązania we własnym środowisku.
Dalej w tym temacie
Claude Cowork dla początkujących – automatyzacja workflow krok po kroku
Większość z nas wciąż używa AI jak zwykłej wyszukiwarki – zadaje pytanie, kopiuje odpowiedź i zamyka okno. Claude Cowork zmienia tę dynamikę: zamiast rozmowy uruchamiasz …
Poradnik6 min czytania
Jak zbudować tarcze ochronne dla agenta AI – 3 metody
Czy Twój agent AI kiedykolwiek zrobił coś, czego się nie spodziewałeś? Nossa Iyamu, inżynier AI i założyciel Getcleed, opracował trzy sprawdzone techniki guardrails, któr…
Poradnik4 min czytania
ChatGPT Wallet: płatności dla agentów AI
Twoje AI może teraz zrobić zakupy, ale nie zobaczy numeru Twojej karty. OpenAI startuje z ChatGPT Wallet - tokeny płatnicze zamiast danych karty, zatwierdzenie Face ID pr…
Agenci AI3 min czytania17 listopada 2026