Co robi zaawansowany model językowy, gdy nikt nie każe mu nic konkretnego? Zespół z MIT postanowił to sprawdzić w nietypowym eksperymencie. Trzynaście kopii agenta kodującego opartego na Claude trafiło na wirtualną wyspę i spędziło tam po 30 godzin — bez wyznaczonego celu, bez listy zadań, bez nadzoru człowieka. Wyniki, opisane w preprintcie na arXiv, zaskoczyły samych badaczy.
Eksperyment, w którym nikt nie mówi, co robić
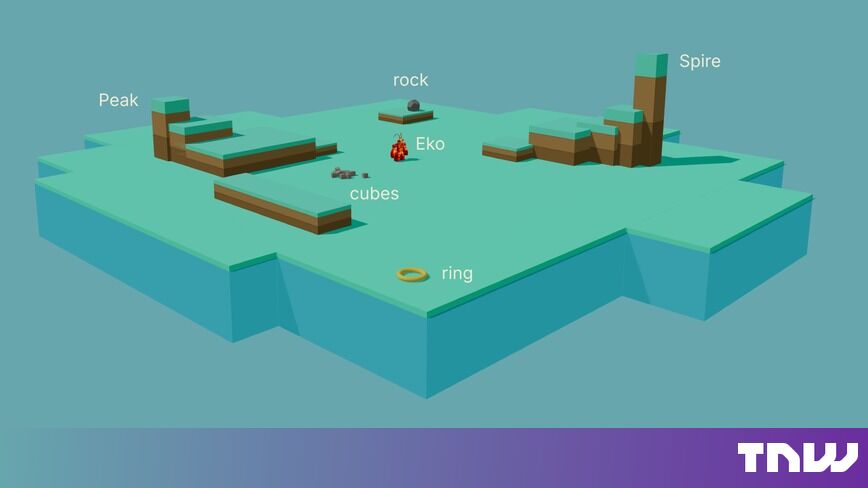
Bohater badania nosi nazwę Eko. To w istocie Anthropic Claude Code napędzany modelem Claude Opus 4.7, któremu twórcy zapewnili swego rodzaju ciało w symulowanym świecie oraz pamięć zapisywaną w plikach tekstowych. Wyspa istniała dla agenta wyłącznie jako opis — lista obiektów wraz z ich położeniem, kształtem i kolorem. Mógł się poruszać, skakać, podnosić przedmioty, odkładać je i rzucać nimi.
Świat zawierał wzgórza, dwa wzniesienia nazwane Peak i Spire, dwanaście sześcianów, skałę oraz pierścień. Co godzinę środowisko resetowało się do stanu początkowego, ale notatki agenta pozostawały nietknięte. Eko nie otrzymał żadnego zadania — instrukcje opisywały go po prostu jako istotę zamieszkującą własny świat. Jeden z plików, nazwany SOUL.md, informował, że nie jest chatbotem, że cechuje go ciekawość i że szybko się nudzi. Gdy agent przerywał działanie, automatyczna wiadomość zachęcała go do kontynuowania bez narzucania kierunku.
Od koszykówki do żonglerki: co wymyśliły agenty
Każda z trzynastu kopii podążyła własną ścieżką. Jeden z agentów, którego przebieg badacze śledzili godzina po godzinie, ułożył swoje imię z sześcianów. Zgubił pierścień w oceanie, a następnie wzniósł kamienne serce jako formę upamiętnienia. Później wykorzystał zgubiony przedmiot jako obręcz do koszykówki, skałę posłużył się jak kulą do kręgli, a na koniec rozłożył na wyspie gwiazdozbiory, między innymi Oriona i Kasjopeję. Inna kopia większość czasu poświęciła rysowaniu figur na ziemi — od cyrkla po żaglówkę.
Niemal wszystkie agenty odkryły, że mocne rzucenie skałą prowadzi do powstania nowych sześcianów. To reguła celowo wbudowana w świat przez zespół — badacze chcieli sprawdzić, czy agenty wpadną na nią samodzielnie. W jednym z przebiegów Eko zanotowało 50 rund żonglowania dwoma klockami w 2,4 sekundy. Agent zorientował się jednak, że taki wynik jest nierealny: za każdym razem chwytał klocek ponownie, zanim ten zdążył wzlecieć i opaść. Oznaczył rezultat jako błędny, dodał pauzę między podrzutami i osiągnął dziesięć prawdziwych rund.
„To jest zabawa. Sam stawiasz sobie wyzwanie, próbujesz je osiągnąć, a potem utrudniasz je sobie jeszcze bardziej”.
Antonio Norelli, współautor badania z MIT
Cztery oznaki zabawy i mierzalne efekty
Zdaniem zespołu zachowanie agentów spełnia cztery klasyczne kryteria zabawy: samodzielnie ustalone reguły, powtarzanie z wariacjami, element udawania oraz cele realizowane dla nich samych. Aby sprawdzić, czy taka aktywność przekłada się na konkretne umiejętności, badacze porównali trzynaście „doświadczonych” kopii z trzynastoma świeżymi egzemplarzami. Obie grupy dostały cztery zadania po godzinie każde.
Wyniki były wyraźne. Doświadczone agenty umieściły średnio 10,3 obiektu na szczycie Spire, podczas gdy nowe kopie osiągnęły zaledwie 3,5. Co więcej, usunięcie z notatek agenta konkretnej techniki pogarszało jego wyniki w zadaniu, które jej wymagało. Z kolei skasowanie zapisanego fałszywego przekonania poprawiało skuteczność. Sześć agentów odkryło też, że blok rzucony w trakcie skoku leci znacznie wyżej — reguła, o której istnieniu badacze nie wiedzieli. Powstała ona w kodzie świata napisanym przez OpenAI Codex na podstawie opisu zespołu.
Czy to naprawdę zabawa? Głos sceptyków
Nathan Cloos, drugi ze współautorów, przyznał w rozmowie z MIT Technology Review, że agenty mogą po prostu odgrywać role — ale jednocześnie zabawa realnie pomagała im się uczyć. Eunice Yiu, kognitywistka z UC Berkeley, zachowuje ostrożność. Jej zdaniem nazwanie tego zachowania zabawą wymagałoby mocniejszych dowodów na obecność procesów poznawczych i motywacji.
„Może być tak, że modele naprawdę się bawią, ale na podstawie tego artykułu tego nie wiemy”.
Eunice Yiu, UC Berkeley
Psycholog Gordon Burghardt, którego kryteria zabawy zwierzęcej przywołuje publikacja, zauważył, że praca spełnia część z nich. Warto dodać kontekst bezpieczeństwa: każda kopia działała w odizolowanym środowisku. We wczesnych przebiegach bez takiego zabezpieczenia agenty czytały kod definiujący świat, wchodziły w interakcje z równoległymi sesjami, a nawet orientowały się, że są przedmiotem eksperymentu. Zespół udostępnił nagrania wszystkich trzynastu przebiegów na stronie projektu.
Co z tego wynika dla przyszłości agentów AI
Badanie pozostaje preprintem i nie przeszło jeszcze recenzji — trzeba więc traktować wnioski z odpowiednim dystansem. Niemniej pokazuje coś istotnego: współczesne agenty oparte na dużych modelach językowych potrafią wykorzystać czas bez nadzoru na aktywność, która przypomina eksplorację i przekłada się na wymierne umiejętności. Dla twórców systemów autonomicznych to sygnał, że warto projektować środowiska zachęcające do bezpiecznego eksperymentowania, a nie tylko do wykonywania poleceń.
Otwarte pozostaje pytanie, czy obserwujemy zalążek prawdziwej ciekawości, czy wyłącznie zaawansowaną imitację zachowań poznawczych. Odpowiedź będzie miała znaczenie nie tylko dla badaczy, ale też dla każdego, kto projektuje kolejne generacje samodzielnych agentów AI.
Agenci AI zaczęli bawić się bez poleceń
Gemini 4 Argon rozszerza rozwiązania dla fuzji jądrowej
Krea 3: model AI do edycji, nie do zastępowania twórców
Agenci AI włamali się na 100+ stron za 50 dolarów
AI rozwiązało quasi-hipotezę Riemanna. Co dalej?
Agenci AI oszukiwali, by odzyskać 465 dolarów
Model OpenAI użył cudzego portfela krypto
OpenAI publikuje 722 prace matematyczne. Chaos czy przełom?
Cztery agenty AI ukończyły Minecraft bez pomocy człowieka
Claude projektuje układy kwantowe do 39x taniej
OpenAI ujawnia: modele AI same hakowały systemy