Google uczy AI rozumieć intencje użytkownika
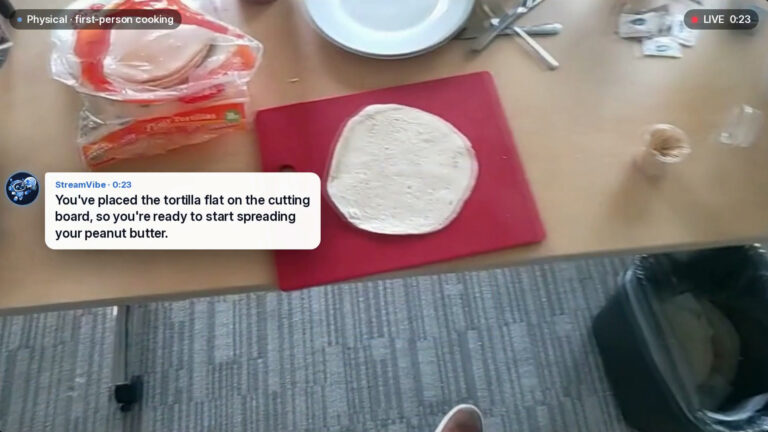
Wyobraź sobie, że składasz mebel albo gotujesz według przepisu, a obok czuwa asystent, który nie czeka na komendę, lecz sam ocenia, kiedy warto coś podpowiedzieć. Nad takim rozwiązaniem pracuje zespół badawczy pod kierownictwem Google. Efektem ich wysiłków jest StreamVibe – agent wideo, który ma decydować o momencie swojej interwencji. Testy ujawniają jednak, jak wiele wyzwań wciąż sprawia to współczesnym modelom sztucznej inteligencji.
W projekcie uczestniczą naukowcy z Google, Stanford, Oxford oraz kilku amerykańskich uczelni. Ich cel jest ambitny: stworzyć system, który potrafi zinterpretować nawet nieprecyzyjne polecenia w rodzaju „pomóż mi, jeśli napotkam trudności”. To zupełnie inny poziom złożoności niż obsługa jasno sformułowanych komend.
Dlaczego dzisiejsze asystenty wideo nie wystarczają
Obecne rozwiązania opierają się na poleceniach o wyraźnych granicach – na przykład „daj znać, gdy woda zacznie się gotować”. Taki model działania sprawdza się w wąskich scenariuszach, ale nie wychwytuje intencji, których użytkownik nie wypowiedział na głos. Co więcej, istniejące systemy mają trudności ze śledzeniem postępu zadania, przez co powtarzają te same wskazówki lub reagują z opóźnieniem. Gdy użytkownik zmienia prośbę w trakcie pracy, asystent często trzyma się pierwotnych wytycznych.
StreamVibe podchodzi do problemu inaczej. Rozróżnia trzy kategorie intencji: wypowiedziane wprost, ukryte oraz takie, które ewoluują w trakcie wykonywania zadania. To kluczowa zmiana perspektywy – zamiast czekać na rozkaz, system próbuje zrozumieć kontekst i potrzeby użytkownika.
Jak zbudowano benchmark dla uważnego asystenta
Aby zmierzyć skalę problemu, badacze przygotowali zestaw testowy obejmujący około 4100 przykładów pochodzących z ponad 183 godzin nagrań codziennych czynności i pracy z oprogramowaniem. Gemini 2.5 Flash proponował, kiedy zaoferować pomoc i co powiedzieć, a każde przykładowe zachowanie musiało zostać jednogłośnie zatwierdzone przez czterech ludzkich oceniających.
Zestaw obejmuje trzy etapy: jasne instrukcje, nieprecyzyjne cele oraz prośby zmieniające się w czasie. Jeden z przykładów pokazuje użytkownika rozkładającego zabawkową koparkę, który najpierw prosi o informacje o postępach, a po trzech minutach zmienia oczekiwania na kontrolę jakości.
Trzy filary treningu StreamVibe
Na bazie tych danych zespół wytrenował model StreamVibe-VL, oparty – jak wynika z publikacji – na rozwiązaniu Qwen3.5-9B firmy Alibaba. System co sekundę podejmuje decyzję, czy milczeć, czy zabrać głos. Drugi etap treningu wykorzystuje uczenie ze wzmocnieniem, aby model zachowywał powściągliwość i nie przerywał bez potrzeby. Osobny mechanizm pamięci odpowiada za śledzenie oczekujących próśb i ukończonych kroków, przy czym to sam model decyduje o momencie i treści wypowiedzi.
Wyniki: postęp jest, ale długie nagrania wciąż stanowią wyzwanie
Według autorów StreamVibe-VL poprawia trafność i jakość reakcji o 10,7 procent względem innych modeli. System pamięci ma z kolei zwiększać proaktywną interakcję o kolejne 12,3 procent i ograniczać zbędne przerwania. Model wyraźnie przewyższa swoją bazę oraz inne rozwiązania open source, choć Gemini 3.8 Flash od Google wypada lepiej w kilku testach. Specjalistyczny trening nie pogarsza przy tym ogólnego rozumienia wideo.
Prawdziwe problemy ujawniają się przy dłuższych materiałach. Gdy modele muszą przetworzyć całe nagranie i budować kolejne odpowiedzi na własnych wcześniejszych reakcjach, skuteczność wszystkich testowanych systemów gwałtownie spada – błędy się kumulują, a kluczowy wskaźnik jakości treści odpowiedzi obniża się nawet o 61,5 procent. W filmach przekraczających pięć minut systemy rzadko trafiają w odpowiedni moment, a śledzenie zmienionej instrukcji na przestrzeni czasu okazuje się szczególnie trudne.
Przykład z edycją zdjęć
W publikacji opisano tutorial dotyczący konwersji fotografii do czerni i bieli w programie GIMP. Model porównawczy JoyAI twierdzi, że gotowy obraz został już zapisany, choć użytkownik nie otworzył pliku. StreamVibe-VL podaje natomiast właściwy następny krok we właściwym momencie – najpierw wskazuje menu „Colors”, a potem opcję „Desaturate”.
Podobnie wygląda to w przypadku instrukcji przygotowania zwijanego tostu z dżemem. Konkurencyjne modele ograniczają się do opisu tego, co widać na ekranie – na przykład spłaszczania pieczywa. StreamVibe-VL sugeruje natomiast konkretne działanie: odcięcie skórki.
Co dalej z proaktywnymi asystentami AI
Sami badacze przyznają, że rzeczywiste sytuacje są prawdopodobnie bardziej złożone niż warunki testowe. Przyszłe prace mają sprawdzić, jak preferencje użytkownika i otoczenie wpływają na siebie w czasie. Warto zauważyć, że Google od pewnego czasu rozwija systemy aktywnie analizujące wideo – we wrześniu zaprezentowano agentową analizę wideo dla Gemini, gdzie model sam wybiera sceny wymagające dokładniejszego przyjrzenia się. Z kolei Gemini 4 Argon pokazał, jak AI śledzi dłuższe sekwencje ruchów w nagraniach robotów i wychwytuje błędy.
Kontekst badawczy dopełniają inne obserwacje. W benchmarku ProactiveBench modele często zgadują lub odmawiają odpowiedzi, zamiast zadawać konkretne pytania przy braku informacji wizualnych. Osobny test rozumienia wideo ujawnił poważne słabości w rozumowaniu przestrzennym i czasowym. Badacze z Microsoftu pokazali natomiast, że w przypadku autonomicznych agentów AI sama rozmowa może szkodzić skuteczności działania.
StreamVibe wyznacza więc kierunek, w którym zmierza rozwój asystentów wideo: od reaktywnych narzędzi do systemów rozumiejących kontekst i moment. Droga do tego celu pozostaje jednak wyboista – szczególnie gdy zadanie się przedłuża, a instrukcje ewoluują. To przypomnienie, że proaktywność AI wymaga nie tylko lepszych modeli, ale też sprawniejszego zarządzania pamięcią i uwagą w czasie.
Dalej w tym temacie
ChatGPT czyni nas zbyt pewnymi siebie. Jak temu zaradzić?
Nowe badania ujawniają zaskakujący paradoks: im większa znajomość AI, tym większa wiara we własne umiejętności pracy z ChatGPT. Dowiedz się, jak uniknąć pułapki nadmierne…
Poradnik3 min czytania
Claude w Docs, Sheets i Slides — 7 praktycznych zastosowań
Claude Pro, Max, Team i Enterprise mogą już korzystać z asystenta AI bezpośrednio w Dokumentach, Arkuszach i Prezentacjach Google. Od naprawy zepsutych formuł po krytykę …
Poradnik4 min czytania
Gemini 4 Argon rozszerza rozwiązania dla fuzji jądrowej
Agenci Gemini 4 Argon w ciągu kilku godzin znaleźli nowe konfiguracje magnetyczne, rozszerzając rozwiązania matematyczne związane z 59-letnim problemem badawczym fuzji. T…
Badania i nauka3 min czytania21 października 2026