
Google prezentuje cztery nowe TPU 8. generacji
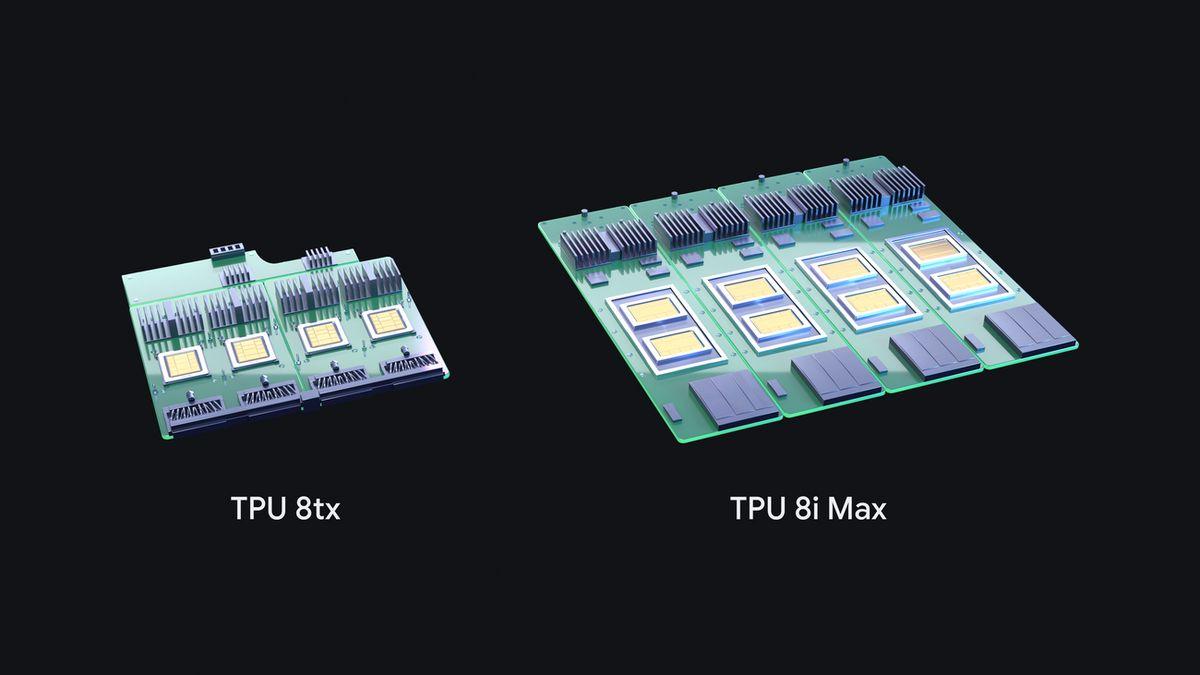
Google rozszerza ósmą generację swoich akceleratorów TPU o dwa nowe systemy: 8tx oraz 8i Max. To wyjątkowy moment, ponieważ po raz pierwszy w historii firmy w ciągu jednego roku zaprezentowano aż cztery układy należące do tej samej rodziny. Wszystko wskazuje na to, że tempo rozwoju infrastruktury AI przyspiesza równolegle z rosnącym zapotrzebowaniem na moc obliczeniową ze strony autonomicznych agentów.
Historia TPU sięga ponad dekady wstecz, kiedy to Google potrzebowało wyspecjalizowanego sprzętu do rozpoznawania mowy i tłumaczenia języków. Dziś zastosowania tych układów obejmują trenowanie i obsługę modeli Gemini, zadania agentowe, usługi chmurowe dla klientów Google Cloud, a także wdrożenia bezpośrednio w centrach danych przedsiębiorstw. Jak podaje firma, biznes związany z TPU rozwija się dynamicznie i obsługuje blisko stu klientów - od laboratoriów badawczych po firmy handlowe i uczelnie.
Nowe układy odpowiadają na realia pracy agentów AI
W kwietniu, podczas wydarzenia Google Cloud Next, zaprezentowano dwa wyspecjalizowane systemy ósmej generacji: 8t, przeznaczony do trenowania wielkoskalowych modeli, oraz 8i, zoptymalizowany pod kątem wnioskowania w czasie rzeczywistym. Według danych producenta pierwszy z nich oferuje do 2,7 razy lepszą wydajność treningu względem poprzedniej generacji, a drugi poprawia stosunek ceny do wydajności wnioskowania o 80 procent.
Dwa nowe systemy rozwijają tę koncepcję. Model 8i Max powstał z myślą o obsłudze bardzo dużych okien kontekstu i maksymalnej gęstości obliczeniowej w pojedynczej szafie serwerowej. Z kolei 8tx skupia się na bezpiecznym i poufnym wnioskowaniu. Jak tłumaczą przedstawiciele Google, firmy coraz częściej proszą o akceleratory zdolne do rozumowania na ogromnych kontekstach, a podmioty z sektorów silnie regulowanych oczekują specjalistycznych mechanizmów szyfrowania dla wrażliwych zadań.
System to coś więcej niż sam układ scalony
Google zwraca uwagę na istotną różnicę między nowym chipem a nowym systemem. Zaprojektowanie układu scalonego oznacza rozplanowanie miliardów tranzystorów na krzemowej płytce w procesie rozciągniętym na lata i ograniczonym prawami fizyki oraz długim cyklem produkcyjnym. System natomiast dotyczy sposobu, w jaki łączy się obliczenia, sieć i pamięć masową wokół chipa - obejmuje to pakowanie, szybką pamięć, sieci optyczne oraz zabezpieczenia.
Od samego początku istnienia TPU inżynierowie Google postawili na modularność i równowagę systemową. Dzięki architekturze opartej na klockach, które można szybko przestawiać, firma jest w stanie dostarczać wyspecjalizowane superkomputery w ciągu miesięcy, a nie lat. To właśnie ta elastyczność pozwala reagować na nowe potrzeby klientów i scenariusze badawcze bez czekania na kolejny cykl produkcyjny półprzewodników.
TPU 8tx: bezpieczeństwo na poziomie sprzętu
Trzeci system ósmej generacji, TPU 8tx, został zoptymalizowany pod kątem poufnego wnioskowania, a dodatkowo dobrze sprawdza się w treningu na mniejszą skalę. Trafi on do przedsiębiorstw regulowanych i instytucji rządowych, które uruchamiają własne modele oraz autonomicznych agentów na najbardziej wrażliwych danych.
Standardowo dane są szyfrowane podczas przechowywania i transmisji, ale muszą zostać odszyfrowane w pamięci, gdy procesor je przetwarza. TPU 8tx rozwiązuje ten problem, przenosząc ochronę na poziom warstwy sprzętowej. Układ powstał na tym samym krzemie co model 8t i współpracuje z procesorami AMD EPYC piątej generacji. Dane oraz wagi modeli pozostają odizolowane nawet w trakcie aktywnego przetwarzania.
Co istotne, system wykorzystuje tę samą sieć Boardfly o niskich opóźnieniach, którą opracowano z myślą o wnioskowaniu w czasie rzeczywistym. Dzięki temu wieloetapowi agenci działają płynniej, a opóźnienia są nawet dwukrotnie niższe niż w przypadku TPU 8t, przy niemal zerowej stracie wydajności. Połączenie mocy treningowej z szybką siecią wnioskowania pozwala zespołom dostrajać modele na prywatnych danych, destylować duże modele do mniejszych oraz trenować agentów metodą uczenia ze wzmocnieniem - wszystko bez migracji wrażliwych informacji między osobnymi klastrami.
TPU 8i Max: przełamywanie bariery pamięci
Czwarty system mierzy się z innym wyzwaniem - tak zwaną barierą pamięci. Gdy dziesiątki agentów AI współpracują nad całym bazą kodu lub godzinami nagrań wideo, przepustowość pamięci szybko staje się wąskim gardłem. Rozwiązaniem okazało się połączenie dwóch niskolatencyjnych układów TPU 8i w jednym pakiecie.
TPU 8i Max skaluje obliczenia i pamięć równolegle, oferując dwukrotnie więcej mocy obliczeniowej, dwa razy więcej pamięci SRAM oraz podwójną przepustowość HBM względem pojedynczego TPU 8i. Dzięki temu procesory mają stały dostęp do niezbędnych danych, a duże zadania nie zatrzymują się w oczekiwaniu na pamięć. Ponieważ podwójny układ mieści się w dotychczasowej przestrzeni szafy serwerowej, centra danych mogą dostarczyć znacznie więcej mocy na metr kwadratowy i na wat energii.
Razem cztery systemy ósmej generacji tworzą kompletny zestaw narzędzi dopasowanych do kolejnych etapów cyklu życia agentów: 8t odpowiada za trening na dużą skalę, 8i za szybkie wnioskowanie, 8tx za poufne przetwarzanie, a 8i Max za ogromne konteksty i najwyższą gęstość obliczeniową w szafie.
TPU stają się dostępne dla każdego programisty
Google równolegle pracuje nad usuwaniem barier we wdrożeniach TPU. Gdy ponad dekadę temu powstawał pierwszy układ, z jego mocy korzystała garstka firm o bardzo wyspecjalizowanych potrzebach. Dziś, wraz z upowszechnieniem AI, akceleratory trafiają do znacznie szerszego grona odbiorców, a producent chce, by były równie łatwe w użyciu jak sprzęt ogólnego przeznaczenia.
Otwartość na PyTorch i narzędzia deweloperskie
W ubiegłym miesiącu Google udostępniło jako open source projekt TorchTPU, dzięki czemu kod PyTorch i modele z Hugging Face działają natywnie na TPU. Pojawiły się też gotowe backendy dla popularnych silników wnioskowania, takich jak vLLM i SGLang. Nowy zestaw narzędzi TPU agent suite, również otwarty, integruje się z edytorami typu Claude Code, Cursor czy Google Antigravity - potrafi zautomatyzować wdrożenie w kilka minut, zdiagnozować wąskie gardła i dostroić własne jądra obliczeniowe za pomocą języka naturalnego.
Wyniki w testach produkcyjnych
W realnych warunkach liczy się nie teoretyczna szczytowa moc chipa, lecz efekty na rzeczywistych zadaniach AI. W branżowych benchmarkach InferenceX i AgentX, sprawdzających kodowanie agentowe oraz pracę z długim kontekstem, stos vLLM-TorchTPU osiągnął czołowe wyniki pod względem stosunku ceny do wydajności. Badania pokazują, że przewagi te utrzymują się na szerokiej gamie otwartych modeli i stosów serwujących, przy zachowaniu wysokiej dokładności. Kolejne optymalizacje oprogramowania mają jeszcze poprawić te rezultaty.
Oszczędzanie energii i przełamywanie bariery pamięci
Agenci AI są stanowi, co oznacza, że często pauzują na sekundy lub godziny w oczekiwaniu na zapytanie do bazy, narzędzie zewnętrzne albo reakcję człowieka. Nowy mechanizm Agent Compute Engine automatycznie wstrzymuje bezczynne sesje i przenosi pamięć roboczą poza chip w milisekundach, co obniża koszty infrastruktury. Z kolei otwarty projekt TPU Sync łączy pamięć HBM, DRAM hosta, pamięć współdzieloną i sieć centrum danych w jedną hierarchię pamięci. Automatycznie przenosi ogromne pamięci KV poza chip, strumieniuje kontekst między węzłami i synchronizuje wagi uczenia ze wzmocnieniem, skracając opóźnienia transferu KV oraz czas do pierwszego tokena o ponad 90 procent.
Zarządzanie klastrami i koordynacja z AI
Google udostępnia także narzędzia do zarządzania rozproszonymi obciążeniami. Cloud Pathways, dostępny ogólnie w Google Kubernetes Engine, przenosi środowisko uruchomieniowe Google DeepMind stojące za Gemini do wszystkich klientów Google Cloud. Dzięki architekturze jednego kontrolera można orkiestrować duże systemy TPU rozproszone na wielu wycinkach tak, jakby były jedną lokalną maszyną - zarówno przy wstępnym treningu, jak i uczeniu ze wzmocnieniem czy wnioskowaniu wielohostowym.
Z kolei GKE dynamic slicing, również ogólnie dostępny, rozdziela fizyczne przygotowanie sprzętu od logicznego formowania wycinków przy użyciu technologii optycznego przełączania obwodów. Pozwala to dynamicznie łączyć kostki TPU w większe topologie lub dzielić je na mniejsze, izolowane zadania. Efektem jest skrócenie czasu uruchamiania zadań nawet pięciokrotnie i szybsze odzyskiwanie po awariach - do 4,5 razy - co przekłada się na lepsze wykorzystanie floty układów.
Współprojektowanie z udziałem AI
Wypuszczenie czterech systemów TPU i zunifikowanego, otwartego stosu oprogramowania w ciągu jednego roku jest możliwe tylko wtedy, gdy architekci krzemu, inżynierowie sieci, zespoły kompilatorów i badacze Google DeepMind pracują ramię w ramię. Coraz częściej sam proces projektowania wspiera sztuczna inteligencja - od systemu uczenia ze wzmocnieniem AlphaChip po Gemini, które dostarcza projekty układów w godzinach zamiast tygodni. To podejście określane mianem prawdziwego współprojektowania ma być jednym z wyróżników Google na tle konkurencji.
Nowe układy pokazują, że wyścig o infrastrukturę AI nie dotyczy już wyłącznie surowej mocy obliczeniowej. Coraz większe znaczenie zyskują bezpieczeństwo na poziomie sprzętu, elastyczność systemów oraz otwartość narzędzi dla programistów. W erze, w której agenci AI stają się pełnoprawnymi uczestnikami procesów biznesowych, pytanie brzmi nie tylko o to, kto zbuduje szybszy chip, ale kto stworzy spójny ekosystem zdolny sprostać wymaganiom zarówno laboratoriów badawczych, jak i silnie regulowanych przedsiębiorstw.
Dalej w tym temacie
AI HAT vs AI HAT+: Który moduł wybrać do projektu AI?
Raspberry Pi AI HAT+ oferuje 40 TOPS i 8 GB RAM dla modeli językowych, podczas gdy AI HAT skupia się na wizji komputerowej z 26 TOPS. Wybór między specjalizacją a uniwers…
Poradnik4 min czytania
Jak wybrać kartę graficzną do AI? Praktyczny poradnik
Poznaj kluczowe parametry kart graficznych dla sztucznej inteligencji. Dowiedz się, jak wybrać optymalny sprzęt do swoich potrzeb i budżetu. Praktyczny przewodnik po loka…
Poradnik4 min czytania
Inteligentne okulary Google i Samsung zmieniają rynek
Google i Samsung połączyły siły z Warby Parker i Gentle Monster, by stworzyć inteligentne okulary napędzane platformą Gemini. Urządzenie wyświetla nawigację w polu widzen…
Sprzęt, chipy i robotyka4 min czytania20 maja 2026