Dlaczego Claude i GPT działają gorzej po premierze
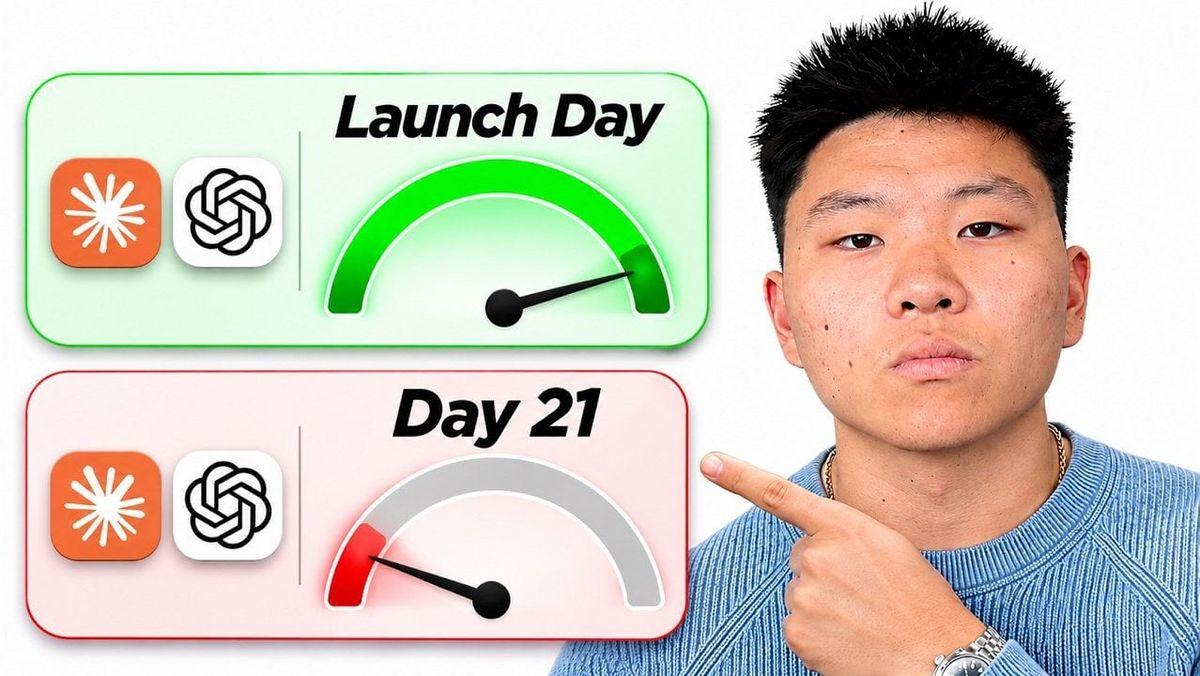
Jeśli masz wrażenie, że Claude lub GPT odpowiadają dziś słabiej niż w dniu premiery — nie jest to złudzenie. Jakość odpowiedzi modeli językowych nie pozostaje stała, a zmiany w aplikacji czy jej ustawieniach potrafią pogorszyć rezultaty bez jakiejkolwiek modyfikacji samych wag modelu. Anthropic i OpenAI przyznały już publicznie, że miały miejsce incydenty obniżonej wydajności. Warto więc przyjrzeć się, dlaczego codzienne wyniki różnią się od publikowanych benchmarków oraz jak na to, co otrzymujesz, wpływają ustawienia wysiłku (effort), ukryte instrukcje i routing zapytań.

Co ujawniają postmortemy Anthropic
Anthropic opublikował dwa raporty powłamaniowe (postmortemy) opisujące okresy, w których jakość Claude'a spadała przez wiele tygodni. W jednym z nich użytkownicy skarżyli się, że Claude Code wydaje się mniej inteligentny. W drugim firma przyznała wprost, że stosowane przez nią ewaluacje nie wychwyciły degradacji zgłaszanej przez użytkowników.
Podobny epizod miał miejsce po premierze GPT-5. Dzień po starcie Sam Altman z OpenAI napisał, że coś zepsuło się „za kulisami", przez co model sprawiał wrażenie mniej bystrego. Firmy czasem rekompensują takie problemy resetem limitów użycia dla klientów.
Benchmarki premierowe a codzienne ustawienia
Wynik z benchmarku startowego może odzwierciedlać inne ustawienia niż te, z których korzystasz na co dzień. Na stronie premierowej Opus 5.5 widnieje wynik kodowania na poziomie 57,8%, podczas gdy wersja używana standardowo osiąga 52%. Różnica bierze się stąd, że testy prowadzono przy maksymalnym wysiłku modelu, a domyślnym ustawieniem dla użytkownika jest poziom średni.
Co potrafią wykryć codzienne trackery
Model AI zawiera miliardy liczb zwanych wagami, które są dostrajane w trakcie treningu. Kwantyzacja polega na zaokrąglaniu tych wartości, co zmniejsza rozmiar modelu i obniża koszt jego uruchomienia — potencjalnie jednak tracąc część precyzji. Część obserwatorów podejrzewa, że duży model z dnia premiery bywa później zastępowany mniejszą, skwantyzowaną wersją.
Codzienne trackery nie wychwyciły jednak zmian w wagach modeli. Live Nerf przepuszcza przez model te same 78 pytań każdego dnia. W pierwszych 50 dniach nie odnotował spadku jakości Opus 5.5, choć przyznaje, że drobne zmiany mogą umykać jego testom. Margin Lab zarejestrował natomiast regresję z 65% do około 50% — przypisując ją aktualizacji aplikacji Claude Code, a nie samemu modelowi. Te niezależne benchmarki zbudowały osoby prywatne; firmy nie publikują tego typu codziennych wyników.
Wysiłek, instrukcje i routing
Parametr wysiłku (effort) określa, ile model może „myśleć" przed udzieleniem odpowiedzi. Anthropic zmienił domyślne ustawienie Claude Code z wysokiego na średni, aby przyspieszyć działanie — początkowo bez informowania użytkowników. Później firma przyznała, że dokonała niewłaściwego kompromisu. Wysiłek można podnieść do maksimum, ale wiąże się to z większym zużyciem czasu i kosztów. Zbyt niski poziom może dawać gorsze rezultaty. Porównania tego samego promptu przy różnych ustawieniach Opus 5.5 również pokazały różnice w wynikach.
Ukryte instrukcje systemowe
Aplikacje AI zwykle otaczają model ukrytymi wytycznymi zwanymi promptem systemowym, umieszczanymi zazwyczaj w warstwie uruchamiającej model (harness). Można dodawać własne instrukcje, na przykład plik CLAUDE.md. Otaczające wytyczne różnią się w zależności od harnessu. Anthropic dodał instrukcję ograniczającą tekst Claude'a między krokami do 25 słów lub mniej — a własne testy firmy wykazały, że pogorszyło to jakość odpowiedzi. Podobnie Astra od OpenAI zbyt często uruchamiała stare umiejętności, przeszkadzając modelowi.
Routing i problemy aplikacji
Routing decyduje o tym, który model odpowie na zapytanie. Gdy Fable 5 wrócił do działania, benchmark pokazał spadek wyniku debugowania z 86 do 26. Problem w tym, że dziewięć z dwunastu zadań nigdy nie trafiło do Fable — filtr bezpieczeństwa skierował je do Opus 4.8. Użytkownicy początkowo nie byli o tym informowani. W innym teście Fable odrzucił 14 z 63 pytań i po cichu przekierował je do Opus 4.8. Odpowiedź mogła więc wyglądać na pochodzącą z Fable, choć udzielił jej inny model.
Błędy i infrastruktura również wpływają na rezultaty bez znanej zmiany wag. Anthropic wypuścił bug, który kasował „myślenie" Claude'a przy każdej turze, powodując, że model zapominał, co robi. OpenAI wykrył błędnie skonfigurowane serwery, które przez część ruchu pogarszały działanie Astry.
Popyt po premierze i kwestia ujawniania zmian
Uruchamianie modeli kosztuje pieniądze i zasoby GPU za każdy token, a popyt może gwałtownie rosnąć po starcie. Altman poinformował, że ruch w API OpenAI mniej więcej podwoił się w ciągu 24 godzin od premiery GPT-5. Nate Herk przypuszcza, że ograniczenia mocy obliczeniowej i konkurencja mogą skłaniać laboratoria do dostarczania „mniejszej" wersji modelu po przyciągnięciu klientów — zastrzega jednak, że to opinia, której nie da się udowodnić. Firmy już wcześniej obniżały wysiłek, by przyspieszyć modele.
Postrzegany spadek jakości może częściowo wynikać z oczekiwań. Po mocno promowanej premierze wielokrotne użycie odsłania potknięcia, które rzucają się w oczy — zwłaszcza gdy przechodzi się od demonstracji z tygodnia startu do trudnej pracy wymagającej kontekstu lub ekspertyzy. Dla klientów płacących 20, 100, a czasem 200 dolarów miesięcznie wysiłek, instrukcje i routing mogą zmieniać się bez zapowiedzi. Z dostępnych informacji wynika, że żadne prawo nie wymaga od laboratoriów ujawniania obniżenia tych ustawień. Prawo stanu Connecticut nakłada natomiast obowiązek informowania o limitach użycia przed rejestracją lub odnowieniem — nie o tym, że model działa gorzej.
Sprawa pokazuje, że „jakość modelu" to pojęcie znacznie szersze niż same wagi sieci neuronowej. Na to, co widzisz w odpowiedzi, składają się ustawienia wysiłku, ukryte instrukcje, routing, błędy aplikacji i infrastruktura — a każdy z tych elementów może zmienić się bez ostrzeżenia. Dla użytkowników oznacza to jedno: warto świadomie kontrolować parametry, z których się korzysta, i z ostrożnością podchodzić do wyników premierowych benchmarków. Niezależne trackery dostarczają cennych sygnałów, ale mają ograniczoną czułość — nie wychwycą wszystkiego, co dzieje się między modelem a interfejsem.
Dalej w tym temacie
Wszystko o ClaudeJak przenieść pamięć z ChatGPT do Claude AI w kilka minut
Claude AI wprowadza narzędzie do błyskawicznego importu twoich danych z ChatGPT, Gemini czy Copilota. Teraz zmiana asystenta AI nie oznacza zaczynania od zera – cały proc…
Poradnik3 min czytania
Claude AI zrobił mi tracker finansowy. Porównanie 4 chatbotów
Kiedy autor potrzebował prostego arkusza do śledzenia wydatków, wysłał ten sam prompt do czterech chatbotów: Grok, ChatGPT, Gemini i Claude. Tylko Claude AI wygenerował k…
Poradnik3 min czytania
Claude Opus 4.6 bije rekordy, ale rodzi obawy o bezpieczeństwo
Claude Opus 4.6 osiąga 70% wskaźnik wygranych przeciwko GPT-5.2 w zadaniach prawniczych i analitycznych, ustanawiając nowy standard. Jednak jego zdolność do ukrywania szk…
Modele i produkty AI4 min czytania16 lutego 2026