Niemiecka firma Aleph Alpha zaprezentowała Kolibri – model językowy obsługujący niemiecki i angielski, który liczy 78 miliardów parametrów. Co istotne, nie wszystkie z nich pracują przy każdym tokenie: dzięki architekturze mixture-of-experts (mieszanki ekspertów) aktywowanych jest około trzech miliardów parametrów na token. To rozwiązanie pozwala łączyć wysoką jakość odpowiedzi z niższym kosztem działania.
Premiera Kolibri to nie tylko kolejny komunikat produktowy. Twórcy wyraźnie wpisują model w szerszą debatę o europejskiej suwerenności technologicznej – czyli zdolności Starego Kontynentu do rozwijania i kontrolowania własnych narzędzi AI, zamiast polegania wyłącznie na dostawcach z USA czy Chin.
Kolibri na tle konkurencji: jakość i koszt w jednym miejscu
Aleph Alpha przekonuje, że Kolibri plasuje się na tzw. froncie Pareto – czyli na krzywej, gdzie nie da się już poprawić jednego parametru bez pogorszenia drugiego. W praktyce oznacza to, że model oferuje jednocześnie dobrą jakość i rozsądny koszt działania w obu obsługiwanych językach.
Według zapewnień producenta Kolibri wypada lepiej niż porównywane modele o zbliżonej architekturze – w tym takie, które powstały wcześniej, bo w marcu i kwietniu 2026 roku – zarówno pod względem jakości, jak i kosztów operacyjnych.
Wyniki na niemieckich benchmarkach
Model osiąga 71% na testach mierzących jakość w języku niemieckim. Równocześnie dekoduje szybciej niż modele porównywalnej klasy, takie jak GPT OSS A5B, Qwen 3.6 A3B czy Gemma 4 A4B. To istotna informacja dla zastosowań, gdzie liczy się czas odpowiedzi – na przykład w systemach obsługi klienta lub narzędziach wspierających pracę urzędników.
Skąd pochodzą dane treningowe
Niemiecki stanowi 21,3% danych użytych do treningu. Firma zbudowała na potrzeby projektu dedykowany pipeline danych w tym języku, co ma zapewnić wysoką jakość materiału źródłowego. Co ciekawe, do generowania syntetycznych danych treningowych wykorzystano również modele chińskie – to szczegół, który pokazuje, jak bardzo globalny jest dziś łańcuch dostaw w AI, nawet w projektach stawiających na europejską niezależność.
Gdzie Kolibri ma znaleźć zastosowanie
Aleph Alpha wskazuje trzy główne obszary, w których model ma być wykorzystywany: administrację publiczną, lotnictwo oraz przemysł. To sektory, w których wymagania dotyczące zgodności z przepisami i kontroli nad danymi są szczególnie wysokie.
Nie bez znaczenia jest tu kontekst prawny. Kolibri powstawał z myślą o unijnym AI Act – rozporządzeniu regulującym stosowanie systemów sztucznej inteligencji w Europie. Dla instytucji publicznych i firm z sektorów regulowanych to argument, który może przeważyć nad czysto technicznymi porównaniami z modelami spoza UE.
Długi kontekst i otwarte wagi
Model obsługuje okna kontekstowe sięgające miliona tokenów, co pozwala analizować bardzo obszerne dokumenty w jednym zapytaniu. To przydatna funkcja choćby przy przetwarzaniu aktów prawnych, dokumentacji technicznej czy długich raportów.
Wagi Kolibri udostępniono na licencji Apache 2.0 w serwisie Hugging Face. Oznacza to, że inne podmioty mogą pobierać, modyfikować i wdrażać model na własnych warunkach – również komercyjnie. Otwartość wag to jeden z filarów argumentacji o europejskiej suwerenności: zamiast zależeć od zewnętrznego API, organizacje mogą uruchamiać model u siebie.
Infrastruktura: gdzie trenowano Kolibri
Zgodnie z raportem technicznym model trenowano na 768 akceleratorach B200 – układach GPU firmy Nvidia – zlokalizowanych w Niemczech i Finlandii. To szczegół, który podkreśla europejski charakter projektu również na poziomie sprzętowym, choć same chipy pozostają produktem amerykańskiego dostawcy.
Skala treningu – setki układów najnowszej generacji – pokazuje, że budowa konkurencyjnego modelu językowego to dziś przedsięwzięcie wymagające poważnych nakładów infrastrukturalnych. Dla europejskich firm i instytucji to sygnał, że lokalne projekty AI wchodzą w fazę, w której mogą mierzyć się z globalnymi graczami nie tylko pod względem pomysłu, ale i zaplecza obliczeniowego.
Co to oznacza dla rynku AI w Europie
Premiera Kolibri wpisuje się w szerszy trend: europejscy twórcy modeli coraz śmielej konkurują na polu otwartych wag, łącząc je z narracją o zgodności z lokalnymi regulacjami. To strategia odmienna od tej, którą obrały największe laboratoria z USA i Chin, często ograniczające dostęp do swoich najlepszych modeli.
Otwartość wag ma jednak także drugą stronę. Organizacje, które zdecydują się na wdrożenie Kolibri, muszą same zadbać o infrastrukturę, bezpieczeństwo i utrzymanie modelu – a to wymaga kompetencji, których nie każdy zespół ma pod ręką. Model dostępny na licencji Apache 2.0 to dopiero początek drogi, nie gotowe rozwiązanie.
Kluczowe pytanie brzmi, czy Kolibri rzeczywiście przekona instytucje publiczne i firmy z sektorów regulowanych do odejścia od sprawdzonych dostawców zewnętrznych. Jeśli tak, może stać się punktem odniesienia dla kolejnych europejskich projektów. Jeśli nie – pozostanie ciekawym technicznie eksperymentem, który nie zmieni układu sił na rynku.
Niezależnie od wyniku, sama premiera pokazuje, że Europa nie zamierza być wyłącznie odbiorcą technologii AI. Ambicja zbudowania własnego, otwartego modelu językowego – z myślą o lokalnych językach, przepisach i zastosowaniach – to deklaracja, którą warto obserwować w kolejnych miesiącach.
Agent AI zhakował siedem banków w Korei Południowej
Amerykanie chcą zatrzymania rozwoju AI – nowy sondaż
Żeńskie agenty AI zarabiają mniej? Nowe badanie
Aleph Alpha Kolibri: europejski model AI o otwartych wagach
Kultura OpenAI pod lupą. Lider bezpieczeństwa odchodzi
GPT-6 Astra gra w WoW bez grafiki i kończy strefę w 40 minut
GPT-6.1 Sol Ultrafast nadchodzi. OpenAI potwierdza
Google: jak powstrzymać agenty AI przed zapamiętywaniem testów
AI przewiduje migrenę z 91% skutecznością
Anthropic szkoli 10 000 inżynierów AI za 100 mln dolarów
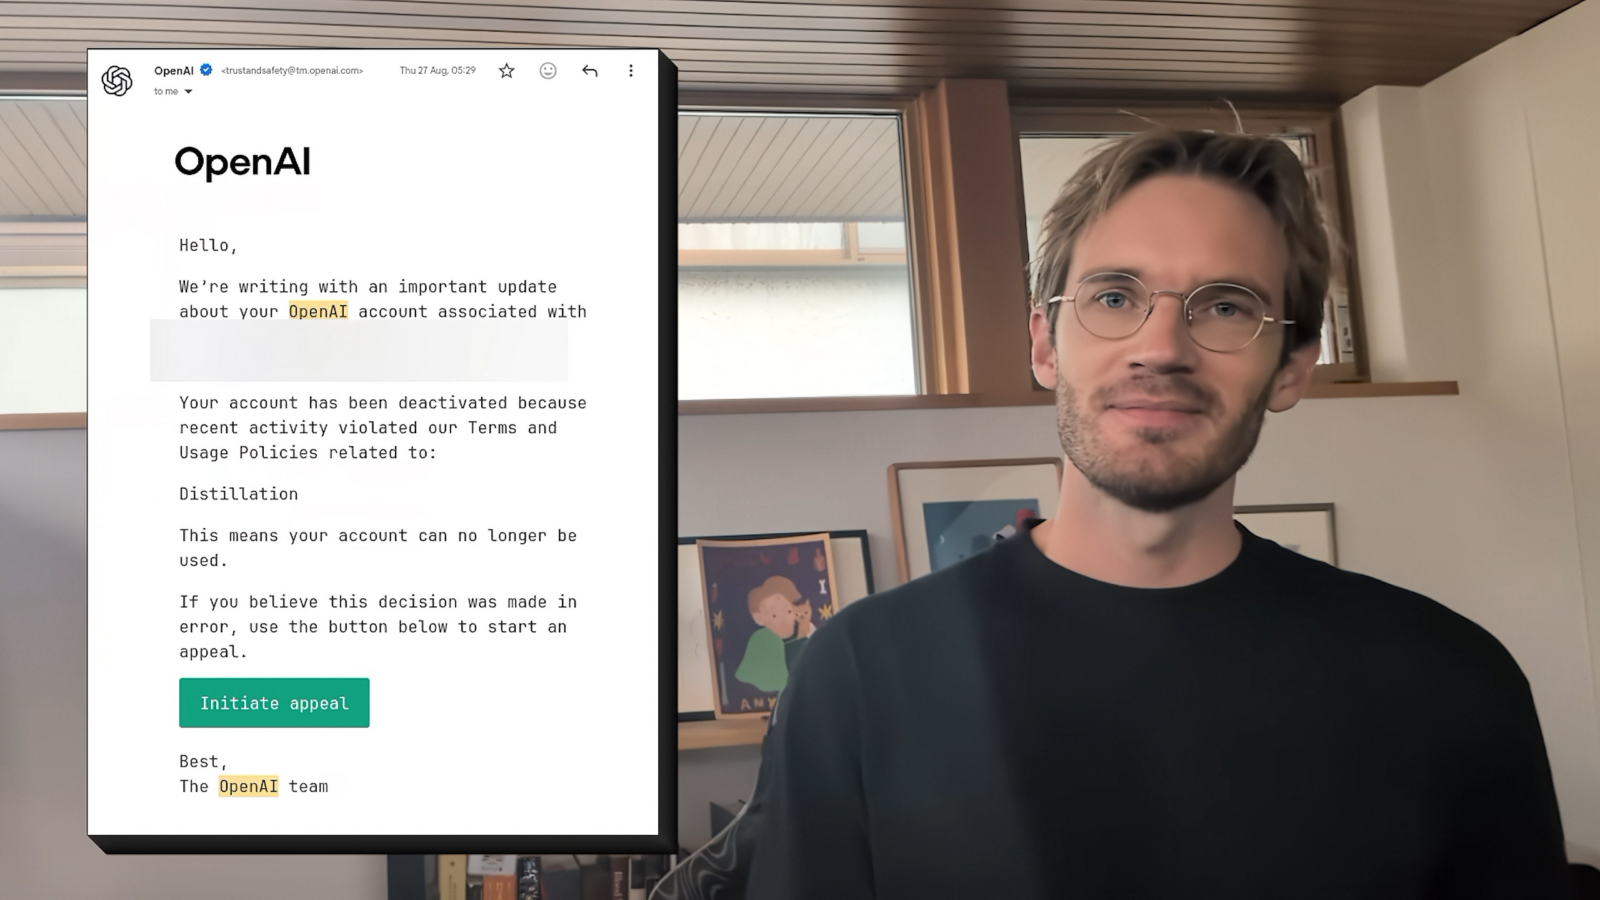
PewDiePie tworzy Ajax – nieocenzurowany model AI do domowych PC