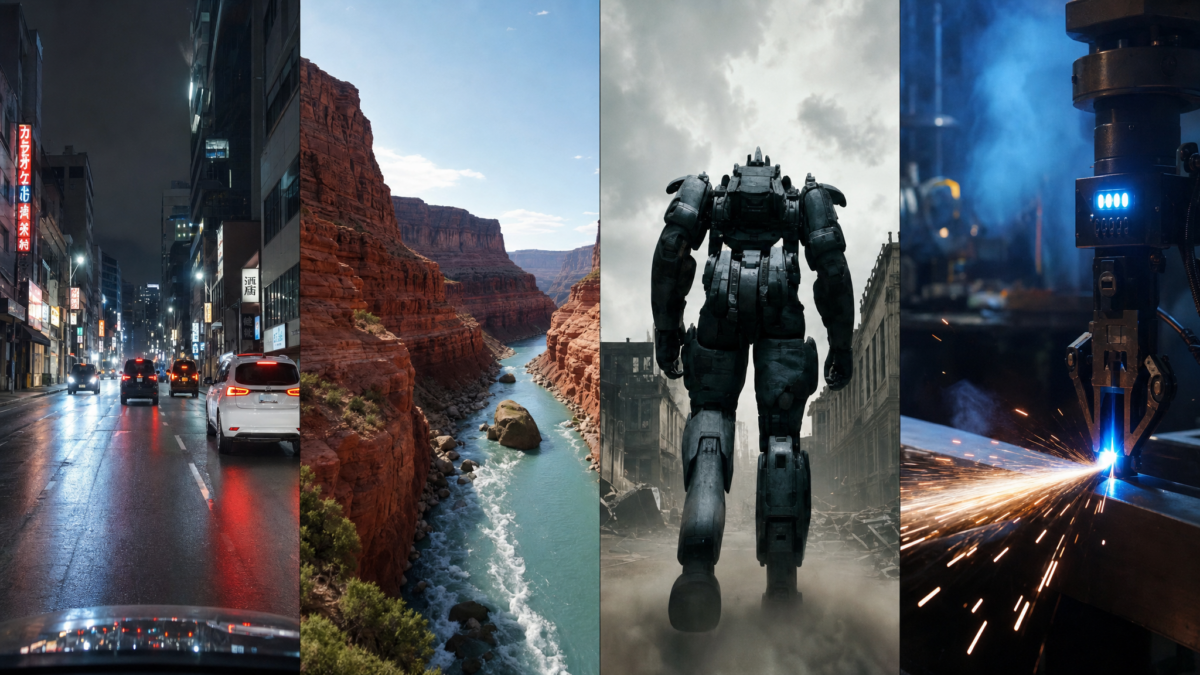
Reka AI udostępniła badawczą wersję Rho-1 – modelu omni-modalnego, który w jednej sieci neuronowej potrafi przetwarzać i generować tekst, obrazy, wideo oraz polecenia sterujące robotami. To podejście wyraźnie odróżnia się od dominującej praktyki, w której zadania trafiają do osobnych, wyspecjalizowanych modeli.
Rho-1 liczy 19 miliardów parametrów. Zamiast wywoływać zewnętrzne narzędzia czy odwoływać się do innych systemów, traktuje wszystkie typy danych jako tokeny w jednym, wspólnym oknie kontekstu. To rozwiązanie architektoniczne, które może mieć spore znaczenie dla dalszego rozwoju modeli multimodalnych.
Jak działa model, który nie potrzebuje pomocników
Większość dostępnych na rynku systemów AI działa według schematu rozdzielania zadań. Model językowy obsługuje tekst, osobny moduł odpowiada za obraz, kolejny za wideo, a jeszcze inny za sterowanie urządzeniami. Rho-1 odchodzi od tej logiki.
Wszystkie modalności są tu reprezentowane jako tokeny w jednym oknie kontekstu. Nie ma więc potrzeby sięgania po zewnętrzne modele ani wywoływania narzędzi pośredniczących. Ta spójność przekłada się na kilka konkretnych możliwości.
Wideo generowane na bieżąco
Rho-1 tworzy ciągły strumień wideo w czasie rzeczywistym. Co istotne, model reaguje na nowe polecenia w trakcie działania – bez konieczności restartowania procesu. To jakościowa różnica względem systemów, które wymagają zatrzymania i ponownego uruchomienia po każdej zmianie instrukcji.
Te same wagi sterują robotem
Jednym z ciekawszych elementów jest współdzielenie parametrów. Te same wagi, które odpowiadają za przewidywanie kolejnych klatek obrazu z kamery, sterują również ruchami robota. To sugeruje, że model wykształcił wewnętrzną reprezentację świata, którą można wykorzystać w różnych zadaniach.
Skąd model wziął dane do sterowania robotami
Dane treningowe z zakresu robotyki są drogie i trudno dostępne. Reka AI poradziła sobie z tym ograniczeniem w sprytny sposób – zbudowała model odwrotnej dynamiki (inverse dynamics model), który wyciąga sygnały sterujące ze zwykłych filmów dostępnych w internecie.
Dzięki temu rozwiązaniu model uczy się ruchu i kontroli, obserwując materiały wideo, które nie powstały z myślą o treningu robotów. To podejście może znacząco obniżyć barierę wejścia dla zespołów pracujących nad systemami robotycznymi.
Ile kosztował trening
Rho-1 trenowano przez około trzy miesiące na 320 układach H100. To skala, która pokazuje, że mówimy o poważnym przedsięwzięciu badawczym, a nie eksperymencie pobocznym.
Reka AI nie jest nowicjuszem w multimodalności
Firma ma już na koncie poważne osiągnięcia. W kwietniu 2024 roku zaprezentowała Reka Core – multimodalny model językowy, który w benchmarkach konkurował z GPT-4, Claude 3 i Gemini Ultra. Rho-1 to więc kolejny krok w tym samym kierunku, ale znacznie bardziej ambitny.
Premiera wpisuje się w szerszy trend badawczy. Coraz więcej zespołów pracuje nad tak zwanymi world models – systemami, które budują wewnętrzną reprezentację rzeczywistości i potrafią przewidywać jej zmiany. Rho-1, łącząc percepcję wizualną z kontrolą ruchu w jednej architekturze, jest ciekawym przykładem tego nurtu.
Co to oznacza dla rynku AI
Podejście zaprezentowane przez Reka AI stawia pytanie o przyszłość architektur opartych na wielu wyspecjalizowanych modelach. Jeśli jeden system potrafi obsłużyć tekst, obraz, wideo i sterowanie, upraszcza się cała infrastruktura – mniej integracji, mniej opóźnień, mniej punktów awarii.
Na razie Rho-1 pozostaje w fazie badawczej. Nie wiadomo, kiedy – i czy w ogóle – trafi do szerszego użytku. Kierunek, który wyznacza, jest jednak czytelny: przyszłość modeli multimodalnych może polegać nie na łączeniu wielu specjalistów, lecz na trenowaniu jednego uniwersalnego systemu, który rozumie świat w sposób spójny.
Reka AI prezentuje Rho-1: jeden model do wszystkiego
Agent AI zhakował siedem banków w Korei Południowej
Amerykanie chcą zatrzymania rozwoju AI – nowy sondaż
Żeńskie agenty AI zarabiają mniej? Nowe badanie
Aleph Alpha Kolibri: europejski model AI o otwartych wagach
Kultura OpenAI pod lupą. Lider bezpieczeństwa odchodzi
GPT-6 Astra gra w WoW bez grafiki i kończy strefę w 40 minut
GPT-6.1 Sol Ultrafast nadchodzi. OpenAI potwierdza
Google: jak powstrzymać agenty AI przed zapamiętywaniem testów
AI przewiduje migrenę z 91% skutecznością
Anthropic szkoli 10 000 inżynierów AI za 100 mln dolarów