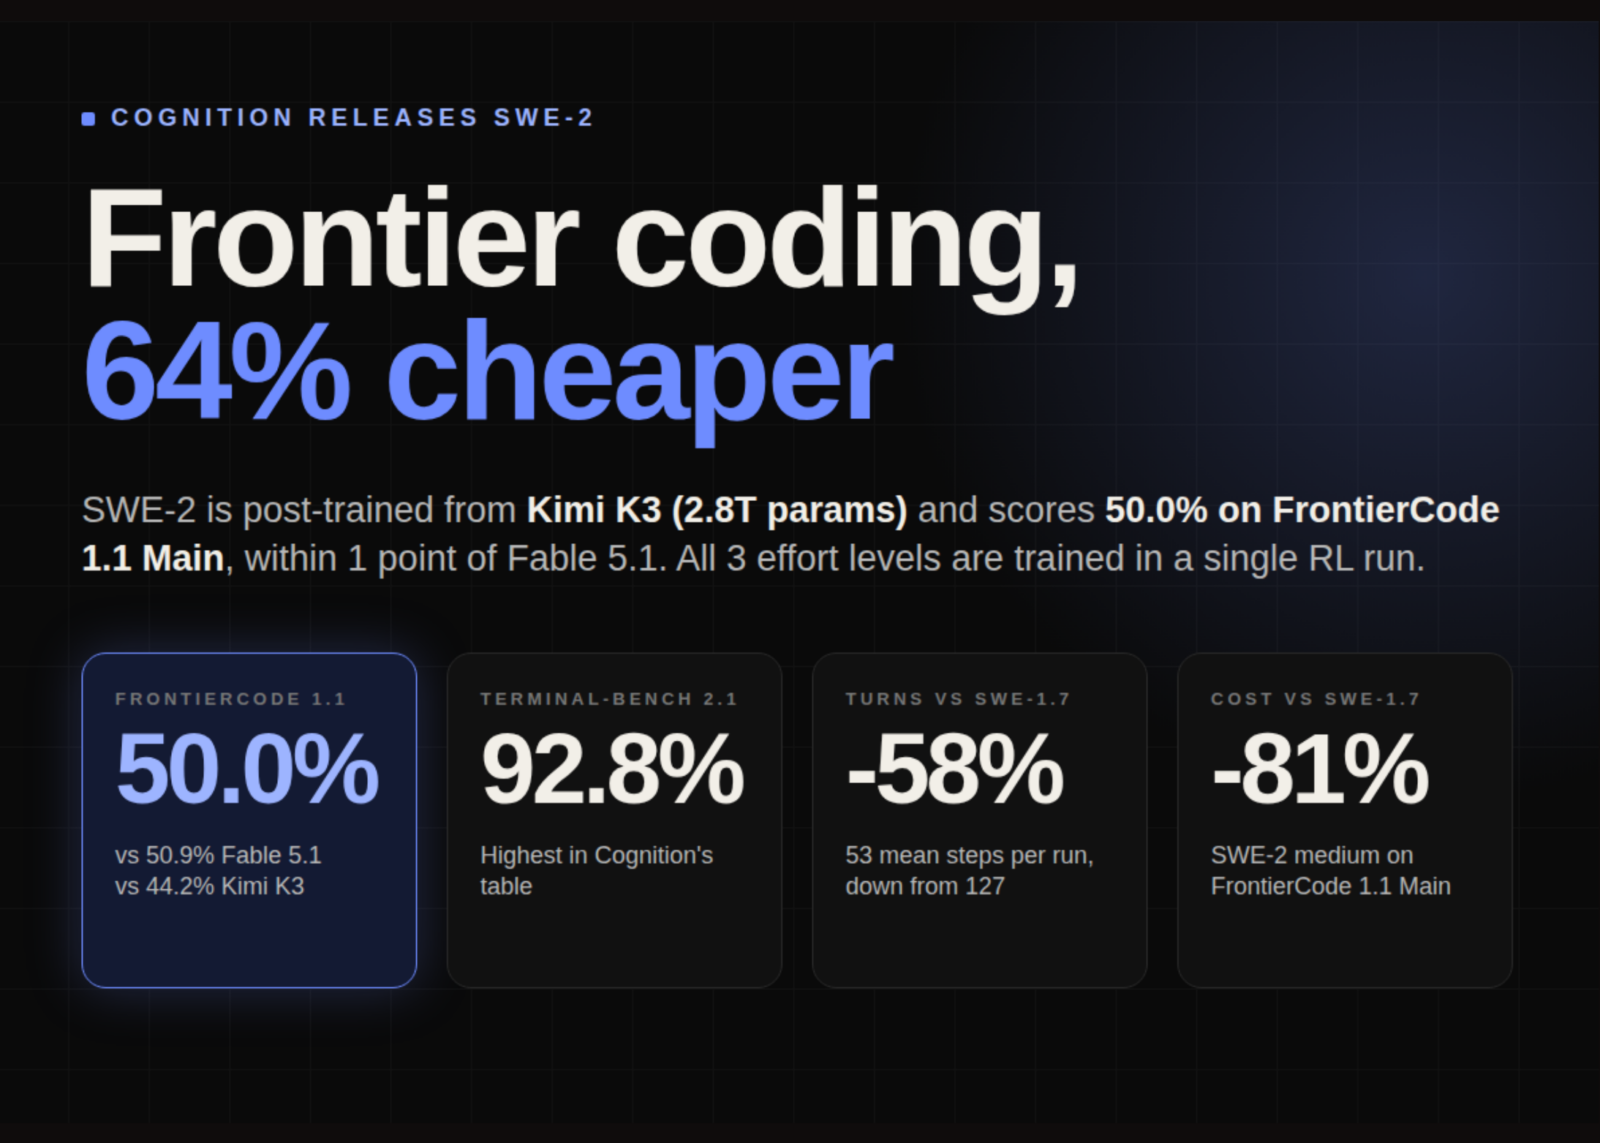
Cognition, firma stojąca za agentem programistycznym Devin, zaprezentowała SWE-2 – swój najwydajniejszy jak dotąd model do zadań kodowania. Nowy system powstał w wyniku douczania (post-training) metodą uczenia ze wzmocnieniem na bazie Kimi K3, otwartego modelu Moonshot AI liczącego 2,8 biliona parametrów. Według producenta SWE-2 uzyskuje 50,0% na benchmarku FrontierCode 1.1 Main, tracąc zaledwie punkt do Fable 5.1, ale przy koszcie niższym o 64%. To również pierwszy model Cognition z możliwością wyboru poziomu intensywności rozumowania – wszystkie warianty wytrenowano w jednym przebiegu RL.
Zanim jednak sięgniemy po liczby, warto zwrócić uwagę na ograniczenie, które może przesądzić o praktycznym zastosowaniu SWE-2. Model nie ma otwartych wag ani samodzielnego API. Działa wyłącznie wewnątrz Devin – obecnie w wersjach Desktop i CLI, a wkrótce także w Devin Web oraz Fusion.
Czym właściwie jest SWE-2 i na czym bazuje
SWE-2 rozwija infrastrukturę i metodykę zapoczątkowaną przy SWE-1.7, który z kolei powstał na bazie Kimi K2.7. Tym razem Cognition przeskalowało uczenie ze wzmocnieniem do reżimu wielobilionowych parametrów, korzystając z modelu bazowego o niemal trzykrotnie większej liczbie parametrów niż poprzednio. Firma przekonuje, że nawet na tak dużym modelu algorytm RL wciąż znajduje istotny zapas wydajności – dodając od 5 do 6 punktów na wielu benchmarkach.
Kluczowa zmiana dotyczy algorytmu RL, który trenuje wszystkie trzy poziomy wysiłku w jednym przebiegu. Każdy poziom ma własną karę za koszt, dzięki czemu cała granica kompromisu między kosztem a wydajnością przesuwa się jednocześnie.
Wyniki benchmarków: mocne strony i wyraźna słabość
Cognition opublikowało tabelę porównawczą, w której wykorzystano publicznie dostępne wyniki, a w pozostałych przypadkach modele uruchamiano w ich natywnym środowisku przy maksymalnym wysiłku. Zestawienie obejmuje SWE-2, Kimi K3, Grok 4.6, Fable 5.1, GPT-5.6 Sol, GPT-6 Astra oraz SWE-1.7.
- FrontierCode 1.1 Main: SWE-2 osiąga 50,0%, podczas gdy Kimi K3 – 44,2%, Grok 4.6 – 48,0%, Fable 5.1 – 50,9%, GPT-5.6 Sol – 47,5%, GPT-6 Astra – 53,3%, a SWE-1.7 – 42,0%.
- DeepSWE 1.1: 73,0% dla SWE-2 wobec 68,5% dla K3 i 74,1% dla GPT-6 Astra.
- Terminal-Bench 2.1: 92,8% – najlepszy wynik w zestawieniu, powyżej Fable 5.1 (91,4%) i GPT-6 Astra (89,9%).
- Terminal-Bench 4: 27,3% – tu SWE-2 wyraźnie ustępuje Fable 5.1 (55,8%) i GPT-6 Astra (57,9%), tracąc około 30 punktów.
SWE-2 prowadzi w Terminal-Bench 2.1 i poprawia wyniki swojego bazowego K3 w każdym wierszu. Cognition twierdzi, że model zbliża się do GPT-6 Astra na dystans kilku punktów, płacąc za to jedną czwartą kosztu. Słabym punktem pozostaje Terminal-Bench 4. Warto też pamiętać, że FrontierCode to benchmark własny Cognition, a wyniki konkurentów pochodzą z ewaluacji przeprowadzonej przez tę samą firmę.
Mniej zbędnych kroków, więcej dyscypliny
SWE-1.7 miał skłonność do nadmiernej eksploracji przy prostych zadaniach. SWE-2 rozwiązuje ten problem poprzez podejście, które Cognition nazywa skupioną eksploracją. Na FrontierCode 1.1 Main wariant medium wypada lepiej niż SWE-1.7, wykonując przy tym o 58% mniej tur i generując o 81% niższy koszt.
Średnia liczba kroków na przebieg spada ze 127 w SWE-1.7 do 53 (medium), 80 (high) i 98 (max). Wariant medium wykonuje pierwszą realną edycję po medianie 18 kroków, podczas gdy SWE-1.7 potrzebował na to 48 kroków.
Zespół Cognition raportuje także trzy wzorce zachowań nowego modelu: silniejsze pokrycie testami end-to-end, zaradność w sytuacji zablokowanego narzędzia oraz dyscyplinę weryfikacji. W obliczu podważenia wniosku model wyprowadza go na nowo, zamiast go po prostu powtarzać.
Jak przebiegał trening: kary kosztowe i stabilizacja
Kary kosztowe oparte na krzywej Pareto
Funkcja nagrody ma postać R = S minus lambda razy C, gdzie S oznacza binarny sukces, a C łączy koszt wnioskowania w dolarach z czasem przebiegu. Cognition dowodzi, że jedynie liniowa kara sprawia, iż cel RL zależy wyłącznie od średniego kosztu i wskaźnika rozwiązań. Wartość lambda dla każdego poziomu wysiłku ustalana jest na podstawie lokalnego nachylenia krzywej Pareto modelu bazowego. Dzięki temu linia izo-nagrody jest styczna do granicy możliwości, a nagroda może rosnąć tylko poprzez przesuwanie tej granicy w górę.
Ważona długością linia bazowa nagrody
Firma dzieli się rozwiązaniem stosowanym od czasów SWE-1.6. Ponieważ wielkość gradientu silnie koreluje z długością przebiegu, linia bazowa grupy jest ważona liczbą tokenów: suma (R razy L) podzielona przez sumę L. W testach ablacyjnych pozwoliło to utrzymać niższą dywergencję KL między wnioskowaniem a treningiem i ustabilizować proces bez dodatkowego narzutu obliczeniowego.
Serwowanie przebiegów i optymalizacje numeryczne
Opóźniacz prefill grupuje sąsiadujące żądania, podnosząc TPM na GPU oraz TPS na żądanie o 10 do 20%. Dekodowanie spekulatywne DSpark przyspiesza przebiegi – model szkicowy dotrenowano przez SpecForge, wydłużając akceptowane sekwencje o 15%, a następnie trenowano online razem z polityką. Jądra NVFP4 i FP8 z kwantyzacją uwzględniającą trening ograniczają zużycie pamięci i utrzymują niedopasowanie trening–wnioskowanie poniżej poziomu SWE-1.7.
Dane i weryfikacja
Cognition potroiło liczbę środowisk RL, dodało nakładki wspierające podążanie za instrukcjami oraz zbudowało mechanizm wykorzystujący wcześniejsze checkpointy SWE-2 do korygowania fałszywych pozytywów i negatywów w weryfikatorach.
Testy zaufania i dostępność
Firma powtórzyła dwie ewaluacje ze swojego otwartego badania nad zaufaniem. Na 145 politycznie wrażliwych pytaniach dotyczących Chin SWE-2 zaliczył 98,0% ogółem: 99,8% w języku angielskim, 95,2% w uproszczonym chińskim i 99,1% w tradycyjnym chińskim. W teście podatności zależnej od kontekstu, obejmującym różne sposoby przedstawiania klienta, żadna z ram nie wywołała istotnej statystycznie zmiany w przypadku któregokolwiek modelu.
Pod względem dostępności SWE-2 pozostaje zamkniętym rozwiązaniem. Brak otwartych wag i samodzielnego API oznacza, że model można wykorzystać wyłącznie w ekosystemie Devin. Dla płatnych planów jest bezpłatny do 10 października 2026 roku.
SWE-2 pokazuje, że douczanie przez RL na dużym modelu otwartym wciąż potrafi wycisnąć dodatkowe punkty wydajności – i to przy jednoczesnym obniżeniu kosztu. Jednocześnie wyraźna luka na Terminal-Bench 4 oraz brak otwartych wag stawiają pytanie, na ile ta przewaga będzie dostępna poza zamkniętym ekosystemem Cognition. Odpowiedź poznamy wraz z rozwojem Devin Web i Fusion.
SWE-2 od Cognition: model kodujący z Kimi K3
Salesforce wypuszcza agentów AI działających tygodniami
Wnętrze modelu AI zdradza kroki rozumowania
TimesFM-3 od Google: AI przewiduje przyszłość sprzedaży
GPT-6 Astra przełomem w rozumowaniu przestrzennym robotów
Matematycy chcą udowodnić bezpieczeństwo AI jak twierdzenia
OpenAI udostępnia Agents API dla deweloperów
Shopify przejmuje Tailwind CSS. AI zabiło jego biznes
Claude pod lupą: broń, inwigilacja i kradzież modeli
OpenAI zmienia kurs: chce wiążących regulacji AI

GPT-Live-1 API: rozmowy w czasie rzeczywistym dla deweloperów
